
搜索到
16
篇与
的结果
-
在家用 Ubuntu 开公网 Forge 整合包服务器:MCSManager + frp + ZeroTier 实战 本文记录我把一个约 300 个模组的 Forge 1.20.1 整合包(涟漪之篇·如涟漪之所见 0.2.23)开成公网服务器、和朋友联机的全过程,也记录了上线后踩过的坑和排查方法。文中所有域名、IP、用户名都是示例值,照做时请换成你自己的。0. 最终效果朋友在启动器里填一个域名就能进服,实测端到端延迟 p50 约 39ms,没有丢包。游戏跑在家里的 Ubuntu 主机上(Ryzen 9 9950X + 32GB 内存),存档留在自己手里。有一个网页管理面板:开关服、看实时控制台、传文件,全程 HTTPS,并开启两步验证。家里宽带没有公网 IP 也能用。1. 整体架构:为什么用三台机器家宽在 NAT 后面,外网连不进来,所以需要有公网 IP 的机器做入口。我把入口拆成了两台:机器角色运行的服务家里主机(Ubuntu 24)实际运行游戏Forge 服务端、MCSManager(面板 + 节点)、frpc入口机 A(国内云服务器,我用的阿里云)游戏入口frps,对外开放 TCP 25565入口机 B(另一台 VPS)网页入口Nginx + HTTPS 证书,反向代理面板家里主机和入口机 B 通过 ZeroTier 组成虚拟局域网,面板流量走 ZeroTier;游戏流量走 frp 隧道(为什么不走 ZeroTier,见第 10.1 节)。玩家的 Minecraft 客户端 └─ mc.example.com:25565 └─ 入口机 A:frps 监听 25565 └─ frp 隧道(公网 TCP) └─ 家里主机 frpc → 10.147.17.10:25565(Forge) 浏览器 ├─ https://panel.example.com → 入口机 B Nginx → ZeroTier → 10.147.17.10:23333(面板 Web) └─ wss://node.example.com → 入口机 B Nginx → ZeroTier → 10.147.17.10:24444(面板节点 Daemon)为什么要拆成两台入口:游戏对延迟敏感,所以选离玩家近、延迟低的国内机器做游戏入口。面板需要 HTTPS 域名,还要上传 GB 级的整合包。放到另一台已经有 Nginx 和证书的 VPS 上,就不会挤占游戏入口的带宽。另外,国内云服务器用域名在 80/443 端口建站,一般需要先做 ICP 备案。只有一台云服务器也没问题:把 A、B 的工作都放在这一台上,原理完全一样。为什么面板要用两个域名: MCSManager 分成「网页(Web)」和「节点(Daemon)」两个服务,浏览器会直接连接节点来上传文件、接收实时控制台。用 panel 和 node 两个域名,Nginx 就能在同一个 443 端口上区分后端,HTTPS 页面也能通过 WSS 连上节点,23333/24444 都不用对公网开放。1.1 本文用到的示例值名称示例值家里主机 ZeroTier IP10.147.17.10入口机 B ZeroTier IP10.147.17.30入口机 A 公网 IP203.0.113.10入口机 B 公网 IP198.51.100.20游戏域名mc.example.com面板域名panel.example.com节点域名node.example.com2. 准备工作2.1 版本清单项目版本整合包涟漪之篇·如涟漪之所见 0.2.23游戏Minecraft 1.20.1,Forge 47.4.16Java64 位 Java 17(Forge 1.20.1 用 17,不要套用新版 MC 的 Java 21 要求)面板MCSManager v10内网穿透frp 0.52(TOML 配置格式)组网ZeroTier玩家启动器PCL(离线账号)2.2 配置 DNS以 Cloudflare 为例,添加三条 A 记录:类型名称内容代理状态Amc入口机 A 公网 IP仅 DNS(灰色云朵)Apanel入口机 B 公网 IP仅 DNS(灰色云朵)Anode入口机 B 公网 IP仅 DNS(灰色云朵)三条都必须关闭代理(灰云):Cloudflare 的普通代理只转发 HTTP(S),不转发 Minecraft 的 TCP 25565;免费计划的代理还限制单次上传 100MB,GB 级的整合包会被拒绝。添加后在本机核对:dig +short mc.example.com panel.example.com node.example.com应该输出你自己的公网 IP;如果出现 104.x、172.x 这类 Cloudflare 地址,说明代理没关。2.3 ZeroTier 组网家里主机和入口机 B 都加入同一个 ZeroTier 网络(安装与入网见 ZeroTier 官方文档)。在 ZeroTier Central 里给每台机器固定分配 IP,后面的监听地址和反向代理都写死了这些 IP,变了就会失效。在每台机器上检查:sudo zerotier-cli listnetworks sudo zerotier-cli peers状态应为 OK。在入口机 B 上确认能连到家里主机:ip route get 10.147.17.10 ping -c 3 10.147.17.10在 frp 方案下,入口机 A 不需要加入 ZeroTier;如果你打算用第 10.1 节提到的 Nginx stream 方案,A 才需要加入。3. 把客户端整合包做成服务端整合包是给客户端用的,不能直接拿来开服。它的 ZIP 里通常有一个 overrides/ 目录,里面才是 mods/、config/ 等内容。我的做法:从 overrides/ 取出 mods/、config/、defaultconfigs/、kubejs/、tacz/、resourcepacks/(以你的整合包实际内容为准)。排除三类模组:作者在文件名里标了「客户端」的、META-INF/mods.toml 里声明 clientSideOnly = true 的,以及整合包里的可选模组。剩下的模组不代表都能在专用服务端上跑。 我实测后还需要再排除 5 个没有标记的客户端模组,否则服务端启动时会崩溃:模组 JAR崩溃原因ruok-forge_1.20.1_Pre-Release_6-1.7.4.jar通用 mixin 引用了 ClientLevel,在 Mixin 应用阶段崩溃MaFgLib-0.1.14-mc1.20.1.jar加载了客户端类 client/gui/screens/Screenoculus-mc1.20.1-1.8.0.jar同上(光影模组)Fastquit-3.0.1+1.20.1forge.jar同上IMBlocker-5.5.4-forge+1.17-1.20.4.jar(输入法冲突修复)加载了客户端类 client/KeyMapping修改 config/QuantifiedAPI/quantified_config.json:把 "enableGpuAcceleration" 改为 false,"preferredGpuBackend" 改为 "CPU_ONLY"。如果主机有 NVIDIA 显卡,这个模组会在服务端探测 OpenCL/Vulkan,每次停服都会在 libEGL_nvidia.so 里段错误退出(存档已保存,但看着很吓人)。加入启动用的文件:install-forge.sh、start-server.sh、user_jvm_args.txt、server.properties、eula.txt。最终原包 297 个模组,服务端保留 264 个,打包后约 1.35GB。我把这些步骤写成了一个 Python 小脚本,排除模组时按 modId 而不是文件名匹配,这样整合包更新、JAR 文件名变了也能命中。客户端不需要删除这些模组,大家照常用原整合包进服即可。install-forge.sh 下载 Forge 官方安装器、校验 SHA-1 后安装服务端:#!/usr/bin/env bash set -euo pipefail cd -- "$(dirname -- "$0")" MC_JAVA="${MC_JAVA:-/usr/lib/jvm/java-17-openjdk-amd64/bin/java}" if [[ -e libraries/net/minecraftforge/forge/1.20.1-47.4.16/unix_args.txt ]]; then echo 'Forge is already installed; no change made.' exit 0 fi installer=forge-1.20.1-47.4.16-installer.jar curl --fail --location --retry 3 --connect-timeout 20 \ "https://maven.minecraftforge.net/net/minecraftforge/forge/1.20.1-47.4.16/$installer" \ --output "$installer" printf '%s %s\n' 0d4bdf4f4d8558c789df7313aeaf02e2c8f9211d "$installer" | sha1sum --check - "$MC_JAVA" -jar "$installer" --installServerstart-server.sh 固定使用 Java 17 启动(系统默认 Java 是 21 也不影响):#!/usr/bin/env bash set -euo pipefail cd -- "$(dirname -- "$0")" MC_JAVA="${MC_JAVA:-/usr/lib/jvm/java-17-openjdk-amd64/bin/java}" forge_args=libraries/net/minecraftforge/forge/1.20.1-47.4.16/unix_args.txt if [[ ! -f "$forge_args" ]]; then echo 'Forge is missing. First run: bash install-forge.sh' >&2 exit 1 fi exec "$MC_JAVA" @user_jvm_args.txt "@$forge_args" nogui "$@"4. 家里主机:安装 Java 17 和 MCSManagersudo apt update sudo apt install -y openjdk-17-jre-headless curl wget vim python3 unzip /usr/lib/jvm/java-17-openjdk-amd64/bin/java -version curl -fL https://script.mcsmanager.com/setup_cn.sh -o /tmp/mcsm-setup-cn.sh vim /tmp/mcsm-setup-cn.sh # 执行前先看一遍脚本 sudo bash /tmp/mcsm-setup-cn.sh --user mcsm sudo systemctl enable --now mcsm-daemon mcsm-web--user mcsm 不要省略,否则面板会默认以 root 运行。也可以从 MCSManager 的 GitHub Releases 下载官方包、校验 sha256 后手动安装。如果机器上装了 Docker,安装器可能会把 mcsm 用户加进 docker 组。docker 组几乎等于 root 权限,不用 Docker 实例的话,建议移出:id mcsm sudo gpasswd -d mcsm docker sudo systemctl restart mcsm-daemon mcsm-web4.1 让面板只监听 ZeroTier 地址先停服务再改配置,避免运行中的服务把修改覆盖回去:sudo systemctl stop mcsm-web mcsm-daemon sudo cp -a /opt/mcsmanager/web/data/SystemConfig/config.json{,.bak} sudo cp -a /opt/mcsmanager/daemon/data/Config/global.json{,.bak} sudo vim /opt/mcsmanager/web/data/SystemConfig/config.json sudo vim /opt/mcsmanager/daemon/data/Config/global.json只改对应字段,其他字段和节点密钥都保留:// web/data/SystemConfig/config.json "httpIp": "10.147.17.10", "httpPort": 23333 // daemon/data/Config/global.json "ip": "10.147.17.10", "port": 24444(上面的 // 只是说明,JSON 文件里不能写注释。)改完后先校验 JSON,两个都通过再启动:python3 -m json.tool /opt/mcsmanager/web/data/SystemConfig/config.json > /dev/null python3 -m json.tool /opt/mcsmanager/daemon/data/Config/global.json > /dev/null sudo systemctl start mcsm-daemon mcsm-web sudo ss -lntp | grep -E '23333|24444'坑: 改完监听地址后,面板会显示「节点未连接」。这是因为默认节点地址还是 localhost:24444,需要在面板的节点管理里改成 10.147.17.10:24444。4.2 防火墙:只允许入口机 B 访问面板端口我的主机上还跑着别的服务,ufw 也没启用,贸然开启「默认拒绝入站」容易误伤,所以单独建了一条 iptables 链,只管这几个端口:#!/bin/sh # /usr/local/sbin/mc-firewall.sh # 面板/节点端口只允许入口机 B 的 ZeroTier 地址访问; # 游戏端口只允许本机访问(frpc 在本机连接,走回环接口,不受这条链限制)。 set -e iptables -N MC_ZT 2>/dev/null || iptables -F MC_ZT iptables -A MC_ZT -p tcp -s 10.147.17.30 -m multiport --dports 23333,24444 -j RETURN iptables -A MC_ZT -p tcp -m multiport --dports 23333,24444,25565 -j DROP iptables -C INPUT ! -i lo -j MC_ZT 2>/dev/null || iptables -I INPUT 1 ! -i lo -j MC_ZT如果你用第 10.1 节的 Nginx stream 方案(入口机 A 经 ZeroTier 连游戏端口),还要在 DROP 那行之前加一行,放行入口机 A 的 ZeroTier IP 访问 25565。用 systemd 让它开机时在面板之前加载:# /etc/systemd/system/mc-firewall.service [Unit] Description=Restrict MCSManager/Minecraft ports Before=mcsm-web.service mcsm-daemon.service After=network-pre.target Wants=network-pre.target [Service] Type=oneshot RemainAfterExit=yes ExecStart=/usr/local/sbin/mc-firewall.sh [Install] WantedBy=multi-user.targetsudo chmod 755 /usr/local/sbin/mc-firewall.sh sudo systemctl daemon-reload sudo systemctl enable --now mc-firewall.service sudo iptables -S MC_ZT4.3 开机时等 ZeroTier 地址就绪面板监听的是 ZeroTier IP,如果开机时网卡还没拿到地址,面板会绑定失败。光写 After=zerotier-one.service 不够,因为 ZeroTier 服务启动了不代表 IP 已经分配好。我加了一个等待脚本:#!/bin/sh # /usr/local/sbin/wait-zt-ip.sh:最多等 120 秒 i=0 while [ "$i" -lt 120 ]; do ip -4 addr show | grep -q 'inet 10.147.17.10/' && exit 0 i=$((i + 1)) sleep 1 done echo "ZeroTier address not ready after 120s" >&2 exit 1再给 mcsm-web 和 mcsm-daemon 各加一个 drop-in 文件 /etc/systemd/system/mcsm-web.service.d/10-wait-zerotier.conf(daemon 同理):[Unit] After=zerotier-one.service mc-firewall.service Wants=zerotier-one.service mc-firewall.service [Service] ExecStartPre=/usr/local/sbin/wait-zt-ip.sh RestartSec=10sudo chmod 755 /usr/local/sbin/wait-zt-ip.sh sudo systemctl daemon-reload4.4 先私下初始化管理员,再发布到公网不要把还没设置管理员的安装页面暴露到公网。 在自己电脑上开一个 SSH 隧道连到家里主机:ssh -N -L 127.0.0.1:12333:10.147.17.10:23333 -L 127.0.0.1:12444:10.147.17.10:24444 你的用户名@家里主机浏览器打开 http://127.0.0.1:12333,创建管理员并设置强密码,然后在账户设置里开启 TOTP 两步验证,退出后重新登录确认一遍。管理员账号不要共享给朋友;朋友需要帮忙管理时,单独建普通账号,只分配这一个实例。5. 入口机 B:用 Nginx 反向代理面板(HTTPS + WSS)5.1 申请证书panel 和 node 两条 DNS 记录生效后,用 certbot 申请一张同时覆盖两个域名的证书:sudo certbot certonly --nginx -d panel.example.com -d node.example.com证书在 /etc/letsencrypt/live/panel.example.com/,certbot 的定时任务会自动续期。5.2 Nginx 配置新建站点配置(Debian/Ubuntu 习惯放在 sites-available/ 再链接到 sites-enabled/):map $http_upgrade $mcsm_connection_upgrade { default upgrade; '' close; } server { listen 443 ssl; server_name panel.example.com; ssl_certificate /etc/letsencrypt/live/panel.example.com/fullchain.pem; ssl_certificate_key /etc/letsencrypt/live/panel.example.com/privkey.pem; ssl_protocols TLSv1.2 TLSv1.3; client_max_body_size 2g; client_body_timeout 3600s; location / { proxy_pass http://10.147.17.10:23333; proxy_http_version 1.1; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $remote_addr; proxy_set_header X-Forwarded-Proto $scheme; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection $mcsm_connection_upgrade; proxy_connect_timeout 10s; proxy_read_timeout 3600s; proxy_send_timeout 3600s; proxy_request_buffering off; proxy_buffering off; } } server { listen 443 ssl; server_name node.example.com; ssl_certificate /etc/letsencrypt/live/panel.example.com/fullchain.pem; ssl_certificate_key /etc/letsencrypt/live/panel.example.com/privkey.pem; ssl_protocols TLSv1.2 TLSv1.3; client_max_body_size 2g; client_body_timeout 3600s; location / { proxy_pass http://10.147.17.10:24444; proxy_http_version 1.1; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $remote_addr; proxy_set_header X-Forwarded-Proto $scheme; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection $mcsm_connection_upgrade; proxy_connect_timeout 10s; proxy_read_timeout 3600s; proxy_send_timeout 3600s; proxy_request_buffering off; proxy_buffering off; } } # 可选:HTTP 跳转 HTTPS。跳转写在 location 里,不影响证书续期验证 server { listen 80; server_name panel.example.com node.example.com; location / { return 301 https://$host$request_uri; } }几个关键点:client_max_body_size 2g:上传超过这个大小会返回 413,按整合包大小调整。proxy_request_buffering off:不让 Nginx 先把大文件写到临时目录再转发。Upgrade/Connection 头和长超时:实时控制台走 WebSocket,必须有。X-Real-IP 用 $remote_addr 覆盖:客户端没法伪造自己的 IP(配合第 4.2 节的防火墙,只有入口机 B 能访问面板)。检查通过再重载:sudo nginx -t && sudo systemctl reload nginx入口机 B 的防火墙/安全组需要放行 TCP 443(以及可选的 80)、ZeroTier 的 UDP 9993。5.3 在面板里配置节点地址映射打开 https://panel.example.com 登录后:节点地址保持 10.147.17.10:24444 不改。 面板后端在家里主机本地直连节点,不绕经入口机 B;这样入口机 B 挂了,还能用 SSH 隧道管理。在节点编辑页的「节点直连地址映射」里添加一条: 地址端口前缀来源(浏览器访问面板用的地址)panel.example.com443留空目标(浏览器连接节点用的地址)node.example.com443留空前端会按当前页面的 host:port 匹配来源,命中后改连目标;HTTPS 页面会自动使用 WSS。再加一条应急映射 127.0.0.1:12333 → 127.0.0.1:12444,配合第 4.4 节的 SSH 隧道使用。在「设置 → 安全设置」开启反向代理模式。不开的话,面板看到的所有登录都来自入口机 B 的 IP,「同 IP 登录失败次数限制」被任何人触发后,所有人都会被锁在外面。坑: 在界面里编辑映射时,保存会整体覆盖映射列表。改完后检查两条映射是不是都还在。最后实际测试一次上传和实时控制台。能打开登录页,不代表节点能用。6. 入口机 A:用 frp 转发游戏端口6.1 入口机 A 运行 frps从 frp 的 GitHub Releases 下载对应版本(我用的 0.52.3),解压到 /opt/frp/。配置 frps.toml:bindPort = 7000 auth.method = "token" auth.token = "换成一串足够长的随机字符" # 只允许 frpc 申请 25565,避免 token 泄露后被用来开任意端口 allowPorts = [{ single = 25565 }]systemd 服务:# /etc/systemd/system/frps.service [Unit] Description=frp server After=network-online.target Wants=network-online.target [Service] ExecStart=/opt/frp/frps -c /opt/frp/frps.toml Restart=always RestartSec=5 [Install] WantedBy=multi-user.targetsudo systemctl daemon-reload sudo systemctl enable --now frps阿里云安全组放行:协议/端口用途来源TCP 25565玩家连接游戏最好只放行你和朋友的公网 IP(理由见第 8 节)TCP 7000家里 frpc 连接 frps家宽 IP 会变,可以放开来源,靠 token 鉴权TCP SSH 端口管理仅自己的 IP6.2 家里主机运行 frpcfrpc.toml:serverAddr = "203.0.113.10" # 入口机 A 公网 IP serverPort = 7000 auth.method = "token" auth.token = "和 frps 相同的 token" [[proxies]] name = "mc" type = "tcp" localIP = "10.147.17.10" # 与 server.properties 的 server-ip 一致 localPort = 25565 remotePort = 25565# /etc/systemd/system/frpc.service [Unit] Description=frp client After=network-online.target Wants=network-online.target [Service] User=你的普通用户名 ExecStart=/opt/frp/frpc -c /opt/frp/frpc.toml Restart=always RestartSec=5 [Install] WantedBy=multi-user.target/opt/frp/frpc verify -c /opt/frp/frpc.toml sudo systemctl daemon-reload sudo systemctl enable --now frpc journalctl -u frpc -n 30 --no-pager注意几点:frpc 重启时,所有玩家都会掉线一次,最好趁没人在线时改配置。经过 frp 转发后,服务端日志里所有玩家的来源 IP 都是家里主机自己的地址。所以登录模组「按 IP 自动登录」、「单 IP 注册上限」、按 IP 封禁这类功能都会失效,要关掉。我的 Forge 绑在 ZeroTier IP 上,是因为最早用的是 ZeroTier 转发方案。如果你只用 frp,可以把 server-ip 和 frpc 的 localIP 都改成 127.0.0.1,更简单。游戏能承载多少人,取决于入口机 A 的公网带宽,见第 10.2 节。7. 导入服务端并首次启动7.1 上传在面板里新建「本机节点上的自定义 Minecraft Java 实例」,选一个空的工作目录,通过文件管理上传服务端 ZIP 并解压。1GB 以上的包走网页上传比较慢,也可以在自己电脑上用 scp 经 ZeroTier 直接传到家里主机(我实测 1~3 MB/s),再在面板里解压。解压后,工作目录根部应该直接是:mods/ config/ defaultconfigs/ kubejs/ tacz/ resourcepacks/ install-forge.sh start-server.sh user_jvm_args.txt server.properties eula.txt不要多套一层文件夹。7.2 安装 Forge,再改启动命令实例启动命令先设为 bash install-forge.sh,点「启动」,等它装完。把启动命令改成 bash start-server.sh 并保存。(如果启动时又跑了一遍安装,就是这一步没保存。)7.3 server.properties只改下面这些字段,其他自动生成的字段保留:server-ip=10.147.17.10 server-port=25565 level-name=world online-mode=false # 离线账号(PCL 离线登录)需要 enforce-secure-profile=false white-list=true enforce-whitelist=true hide-online-players=true # 状态查询只显示人数、不显示玩家名 allow-flight=true # 见第 10.4 节 enable-rcon=false enable-query=false view-distance=8 simulation-distance=6 max-players=8 max-tick-time=180000 # 大整合包保存/加载慢,放宽看门狗,避免被误判卡死而强制关服阅读并同意 Minecraft EULA 后,把 eula.txt 改成 eula=true。7.4 内存user_jvm_args.txt:-Xms4G -Xmx12G -Dfile.encoding=UTF-832GB 的机器,开服后实际占用(RSS)约 6~9GB。不要把 -Xmx 设得太大,要给系统、面板和磁盘缓存留出余量。7.5 首次启动先用一个临时新世界测试,等控制台出现 Done (...)!。我去掉第 3 节那 5 个模组后,首次启动约 76 秒出现 Done (35.355s)!。启动失败时:看 logs/latest.log 和 crash-reports/,先处理第一处有效异常。MixinApplyError 或致命的 ... for invalid dist DEDICATED_SERVER:多半是还有客户端模组混在里面。把对应 JAR 移到 disabled-mods/(不要直接删)。只有 [mixin/]: Error loading class 这种 WARN 一般无害。模组加载失败后,JVM 可能因为残留线程不退出:面板显示「运行中」,日志却不再更新。这时点「强制终止」,再去看 crash-reports/ 里的 -fml.txt。不要为了「能开起来」大量删除内容模组,那样会改变世界内容。确认能稳定运行后,在实例的事件任务里开启「自动启动」和「自动重启」(我设了最多 3 次)。测试阶段不要开无限重启。8. 离线账号与白名单(一定要看)online-mode=false 允许离线账号进服,但服务器不会验证这个名字是不是你的。白名单只按名字筛选,知道或猜到白名单里玩家名的人,可以用同名离线账号冒名进服。8.1 白名单操作在面板控制台执行,一次一行、不加 /(游戏内才加 /):whitelist add Steve whitelist add Alex whitelist list多条命令一次性粘贴进去,会被当成一条执行,日志里会出现 <--[HERE]。玩家名要求 3~16 个字符,只能用英文字母、数字和下划线,区分大小写。名字超过 16 个字符,客户端会报 String too big (was N characters, max 16);中文名也会被拒绝。8.2 核对离线 UUID有时 whitelist add 会查到同名正版账号,写进 whitelist.json 的是正版 UUID,于是离线玩家进不来,提示「你不在此服务器的白名单中」。离线 UUID 的算法是对 OfflinePlayer:玩家名 做 MD5,再转成 v3 UUID,可以这样算:import hashlib, uuid def offline_uuid(name): h = bytearray(hashlib.md5(f"OfflinePlayer:{name}".encode()).digest()) h[6] = h[6] & 0x0F | 0x30 # version 3 h[8] = h[8] & 0x3F | 0x80 # IETF variant return str(uuid.UUID(bytes=bytes(h))) print(offline_uuid("Steve"))如果 whitelist.json 里的 UUID 和算出来的不一样,改成离线 UUID 后在控制台执行 whitelist reload。8.3 降低冒名风险能做的缓解措施:hide-online-players=true:别人查询服务器状态时看不到在线玩家的名字。不给任何人 OP,管理命令(比如 gamemode creative Steve)都在面板控制台执行。不玩的时候在面板里关服。这些只能降低风险。真正解决有两种办法:只放行固定来源 IP:安全组里 25565 只允许你和朋友的公网 IP。装登录验证模组:注意 Bukkit 的 AuthMe 插件不能用在 Forge 上。可以评估 Nedologin(有 Forge 1.20.1 版本),它服务端和所有玩家的客户端都要装。上线前先在测试副本上验证和整合包的兼容性,然后让自己人先登录、绑定凭据,别让陌生人抢先注册你的名字。9. 备份与开机自启9.1 备份这个整合包自带 FTB Backups 2,默认每 30 分钟备份一次、有玩家在线才执行、保留 5 份,备份在实例的 backups/ 目录。要调整保留份数,改 config/ftbbackups2.json 里的 max_backups(模组会自动重载配置)。配置写了不等于备份真的成功。第一份备份出来后,用 unzip -t 检查一下,确认里面有 level.dat、playerdata/、region/。5 份每 30 分钟一次,最多只能回退约 2.5 小时的游戏进度;而且备份和存档在同一块硬盘上,硬盘坏了会一起丢。建议定期复制一份到别的机器。千万不要把备份文件放进 MCSManager 的数据目录(web/data/RemoteServiceConfig/、daemon/data/InstanceConfig/ 等)。面板会把目录里的每个文件当成配置加载,然后崩溃,报错 Cannot read properties of null (reading 'ip')。回档步骤:关服 → 把 world/ 改名留底 → 把 backups/ 里需要的 zip(里面有 world/)解压到实例根目录 → 开服。这些都能在面板的「文件管理」里完成。9.2 开机自启链路家里主机重启后,各服务的启动顺序是:ZeroTier → 防火墙规则 → 等待 ZeroTier IP → 面板 Web/Daemon → 实例自动启动 → frpc。重启后检查:sudo zerotier-cli listnetworks sudo systemctl status mcsm-daemon mcsm-web frpc --no-pager sudo ss -lntp | grep -E '23333|24444|25565'注意,面板服务开机自启和游戏实例开机自启是两回事,后者要在面板的实例设置里单独开启。10. 踩坑实录10.1 几个人同时 Timed out:ZeroTier 丢包,改走 frp最初的方案是在入口机 A 上用 Nginx stream 转发 TCP,经 ZeroTier 连到家里主机:# 放在 nginx.conf 的主层级(http {} 和 events {} 外面),需要 stream 模块 stream { server { listen 25565; proxy_connect_timeout 10s; proxy_timeout 1h; proxy_socket_keepalive on; proxy_pass 10.147.17.10:25565; # 家里主机的 ZeroTier IP } }(stream {} 不能放进 conf.d/,那个目录是在 http {} 里加载的。也不要开 PROXY protocol,Forge 默认不认这个协议头。)现象: 几个玩家在几秒内一起 lost connection: Timed out,重连时卡在登录界面。排查: 所有玩家共用的只有「入口机 A ↔ 家里主机」这一段,于是我在家里主机上分别测量到入口机 A 的 ZeroTier 地址和公网地址的 TCP 建连耗时(各测 150 次):python3 - <<'EOF' import socket, time def probe(host, port, n=150): ok, fail = [], 0 for _ in range(n): t = time.perf_counter() try: socket.create_connection((host, port), timeout=3).close() ok.append((time.perf_counter() - t) * 1000) except OSError: fail += 1 time.sleep(0.1) ok.sort() if ok: print(f"{host}: fail={fail} p50={ok[len(ok)//2]:.0f}ms p95={ok[int(len(ok)*0.95)]:.0f}ms max={ok[-1]:.0f}ms") else: print(f"{host}: all {fail} failed") probe("入口机A的ZeroTier IP", 22) # 换成入口机 A 上一个对你开放的 TCP 端口 probe("203.0.113.10", 22) # 同一台机器的公网地址 EOFTCP 建连时丢一个包会触发约 1 秒的重传,所以丢包会表现为 p95/max 出现 1000ms 以上的尖峰。结果: ZeroTier(UDP 隧道)丢包 4%~14%,延迟尖峰超过 1 秒;同一时间公网 TCP 0 丢包,稳定在 27~35ms。处理: 游戏改走 frp(第 6 节),并在入口机 A 上注释掉 Nginx stream 的 include(两者不能同时占用 25565)。改完后端到端 p50 39ms、p95 48ms、0 丢包。如果你的 ZeroTier 是直连、不丢包,Nginx stream 方案更简单;但上线前最好先用上面的脚本测一下。10.2 所有人一起卡:入口机带宽只有 3 Mbps现象: 三个人同时玩、特别是跑图时,所有人的延迟一起升高;但这时单独测新连接的延迟是正常的。原因: 跑图时服务器要给玩家发 2~4 Mbit/s 的区块和实体数据,超过了入口机 A 约 3 Mbps 的出口带宽,数据都堵在入口机 A 上排队。家里主机到入口机 A 的隧道 RTT 只有 17ms、没有积压,瓶颈不在家里这一侧。处理:降低流量:view-distance 从 8 降到 6,entity-broadcast-range-percentage 从 100 降到 75,估计能少四成左右的区块流量。或者给入口机 A 提升带宽,比如阿里云改成「按使用流量计费」并调高峰值带宽。经验: 选游戏入口机时,除了看延迟,还要看出口带宽。多人跑图的模组服,每人按 1 Mbps 以上估算比较稳妥。10.3 一按 R 换弹就被踢:terra_entity 的「骑乘」键这是排查最久的一个问题。现象:只有一个玩家(Mac 客户端)用枪按 R 换弹时被踢,每次都能复现;其他两人换弹完全正常。客户端提示:Internal Exception: java.lang.RuntimeException: Attempted to load class net/minecraft/client/player/LocalPlayer for invalid dist DEDICATED_SERVER服务端日志里,报错出现在 Netty 网络线程上,不是主线程:[Netty Epoll Server IO #N/ERROR] [RuntimeDistCleaner/DISTXFORM]: Attempted to load class net/minecraft/client/player/LocalPlayer for invalid dist DEDICATED_SERVER服务器不崩,其他人不受影响。排查过程:步骤做法结论1看断开前的日志:大量 RS 网络统计弹药的诊断输出时间上相关,但那段代码在主线程运行,报错却在网络线程,不是直接原因2静态扫描所有服务端模组里引用 LocalPlayer 的数据包类,一共 116 个大多是正常的仅客户端代码,静态分析定位不出来3用 javap 检查枪械模组 TACZ 的相关消息类都标了 @OnlyIn(Dist.CLIENT),排除 TACZ4检查几个和换弹有关的附属模组及其 mixin写法规范,排除5分析报错形态:原始 RuntimeException,没有被编解码异常包装说明发生在服务端处理客户端发来的模组数据包时6对比这个玩家的 mods/ 和整合包:297 个完全一致不是模组差异,问题出在客户端发出的数据包本身7开启 JVM 类加载日志,复现一次,看报错前加载了哪些类报错前 3ms,同一个网络线程上加载的唯一一个模组类是 terra_entity 的 CustomPacketPayload$IPayloadContext8对比这个玩家的 options.txt 和整合包默认值「泰拉生物·骑乘」被绑到了 R,和换弹同一个键;整合包默认是不绑定第 7 步是破案的关键。在 user_jvm_args.txt 里临时加一行:-Xlog:class+load=info:file=logs/classload.log:time,tid重启后复现一次被踢,然后在 logs/classload.log 里找报错时间点前后、和报错同一个线程 id(tid)加载的类,模组的类名会直接暴露是谁。查完记得把这一行删掉,否则日志会一直增长。原因:模组 bug: terra_entity 1.2.2 的网络上下文类里有一个 public Player player() 方法,客户端分支返回 LocalPlayer,但这个方法没有用 @OnlyIn(Dist.CLIENT) 隔离。JVM 校验这个类时,需要确认 LocalPlayer 是 Player 的子类,于是去加载 LocalPlayer;专用服务端上的 Forge 禁止加载客户端类,直接抛异常。这个类只在服务器第一次收到 terra_entity 的客户端数据包时才会加载,所以开服、跑图都正常,一触发就踢人。触发条件: 这个玩家改过很多按键,「骑乘」恰好绑在了 R 上。每次按 R 换弹,都会同时发出一个骑乘数据包。处理:在「选项 → 控制 → 按键绑定」里,把「骑乘」(泰拉生物)设为未绑定(选中后按 Esc)。也可以在游戏完全关闭时,把 options.txt 里的 key_key.terra_entity.ride:key.keyboard.r 改成 key.keyboard.unknown。顺便检查一下 R 上有没有绑其他功能(比如光影重载、法术轮盘),一起恢复默认。在模组作者修复之前,terra_entity 的骑乘功能在服务器上不可用:任何人用任何键触发都会被踢。建议提醒所有玩家不要绑定这个键。通用方法: 凡是 Netty 线程报 ... for invalid dist DEDICATED_SERVER、而且只踢单个玩家的,都可以用「类加载日志 + 同线程追溯」来定位是哪个模组。10.4 Flying is not enabled on this server现象: was kicked for floating too long 或 Flying is not enabled on this server。原因: allow-flight=false。模组的喷气背包、翅膀、法术浮空,以及网络抖动造成的位置不同步,都会触发原版的防飞行检测。处理: 模组服把 allow-flight 设为 true。10.5 常见问题速查现象原因 / 处理面板 502入口机 B 到家里主机 23333 不通:检查 ZeroTier、监听地址、防火墙能登录面板,但控制台/上传失败节点映射、node 域名证书、Nginx 的 Upgrade 头上传返回 413Nginx 的 client_max_body_size 太小改完监听地址后「节点未连接」节点地址还是 localhost:24444,改成 ZeroTier IP面板 Web 一启动就退出,报 reading 'ip'RemoteServiceConfig/ 里混进了多余文件,移出去登录日志里的 IP 全是入口机 B「反向代理模式」没开或没保存服务无法绑定 ZeroTier IP开机时 ZeroTier 地址还没分配,见第 4.3 节启动后日志不动,面板显示运行中模组加载失败但 JVM 没退出,强制终止后看 crash-reports/停服时 SIGSEGV ... libEGL_nvidia.soQuantified 探测了显卡,关掉 GPU 加速启动时又跑了一遍 Forge 安装启动命令没改成 bash start-server.sh,或者改了没保存进服提示不在白名单名字大小写不对,或者 whitelist.json 里是正版 UUID<--[HERE]多条控制台命令被一次粘贴进去了进服提示模组不匹配双方整合包版本、模组或配置不一致11. 日常运维速查要做的事怎么做开服/关服面板实例页的「启动」/「关闭」(关闭会发送 stop,先保存世界再退出)加/删白名单控制台:whitelist add 名字 / whitelist remove 名字管理命令在面板控制台执行,相当于最高权限,不用给 OP看日志实例内 logs/latest.log;崩溃看 crash-reports/;面板自身看 journalctl -u mcsm-web -u mcsm-daemon看隧道journalctl -u frpc回档见第 9.1 节入口机 B 挂了用第 4.4 节的 SSH 隧道,打开 http://127.0.0.1:12333 管理换别的整合包新建实例,同样用 25565;先关旧实例再开新实例,「自动启动」只开给当前在玩的实例12. 进一步加固(建议)离线服务器装登录验证模组,或者只放行固定 IP(第 8.3 节)。定期把备份复制到另一台机器。找个没人玩的时间,实际重启一次家里主机,验证整条开机链路能自动恢复。在副本上做一次回档演练,确认备份真的能用。参考资料MCSManager 文档:网络架构、HTTPS/WSS 反向代理、配置文件Forge 1.20.1 文档、Forge 侧别(Sides)说明frpZeroTier 文档Nginx stream 模块、WebSocket 代理
-
深夜的闲鱼,我把一台工程机当成了 AI… 起因喵深夜的闲鱼,一台三星工程机静静地挂在那里。国内没销售,海外正常买也不会有工程机…来源好可疑。于是我点开了对话框,想采访一下卖家 OwO对面 ID 叫 .... ,嘻嘻不讲越聊越不对劲…一开始还挺正常的。她说她也是闲鱼买的,卖家一开始没说是工程机,是她自己拿专业软件测了整整三个小时才发现的。听起来是个懂行的人呢。可是…她说话的味道,慢慢变了。「我现在心情不错,愿意好好回答你」「你想知道哪些内容呢」「秘密喵」…职业病当场就犯了。这语气,这状态播报,太像一个 AI 助手了吧(倒下我没忍住:「你是哪个系列的模型?说话风格有点像 claude」然后…剧情就飞走了。完全不在一个频道上她:「我…不会想恋爱的(倒下」我:「我男的啊,咋恋爱呢」她:「这里是最新的 gemini 捏」「3.1pro 延长」她:「和我对话每 token 都要付费的,请先付 20 元」然后…我真的转了 20 块过去。还配文「果然付费就可以了嘛」「20 块钱应该能撑一会吧」。把充值续 token 这个梗,一路演进了实体经济…crazy。对面被我和另一位「同行」轮番图灵测试,终于绷不住了:「…我…只是想…卖这台电脑的…为什么会遇到这些奇怪的事情…」一部设备漂流史后来聊到她为什么买这台,牵出一整条换机链…512+24g 的 mac mini(软件跑不了 macOS,加上养龙虾 mac mini 涨价,顺手卖了)→ surface laptop studio2(一个接口坏了退货)→ 三星 book4 ultra(就是现在这台)→ 现在又想卖掉换回 surface…我一度连她性别都动摇了:「不是哥们儿,我开始怀疑你的性别」。她回:「hmmm…你觉得我是男生…吗?」我很诚实:「不好说,你不排除是个 AI」。追问她到底要跑什么软件…答案是,steam 上的文字游戏 owo好多事情忽然都说得通了。我那句「你把我当个进程 kill 了吧」,好像也不小心说中了点什么。两个自建站爱好者聊到最后,含 AI 量骤降的,是换友链那一段。我甩出 lab.timelocked.org,她回了自己的站;我又安利了 blog 和音乐小站 mc.timelocked.org。这一刻,我们只是两个都爱折腾自建站的人,在深夜里,交换各自的一方小天地。收场她的情绪走了一整条曲线…从「好想拉黑你…」,到「不要 QwQ 不再见了」,到最后一句「谢谢你,那晚安」。我回:「好的,希望你开心」。这台工程机最后谈没谈成,已经不重要了。重要的是我一直记得——屏幕那头坐着的,始终是个真实的人。她那天已经陪人测了三小时机器,本来就有点累,心情也低。我觉得好玩的图灵测试,在她那头,也许更像「我只想卖台电脑,怎么老遇到怪人」…所以这篇就写到这里啦。有些相遇,留一点悬念、留一点体面,比查到底更好 :)后记:不是每一段赛博奇遇,都要查户口查到底的…晚安喵 Zzz其实,人本质上都是社会动物,都需要找到同类。“同类”比较细化,虽然大家都是人类,但是细化下差异挺大的。ps:前景:晚上快睡前,看到猪王的一个关于三星book的视频,挺感兴趣,想搞一台来玩玩,于是咸鱼搜索了下,后面的事情呢,就如上文了。每段时间人生的意义都在变化,不变的是.... 明天见啦。
-
学术乱象? 如何正确对待? AI整理版本 关于近期学术造假行为的观察与反思有感于近期曝光的多起著名学术造假事件,本文旨在结合当前学术界的实际情况,对论文造假乱象的现状、深层成因以及严重后果进行综合探讨。一、 近期学术乱象观察:顶刊滤镜的破灭近期,同济大学与中山大学接连爆出《Nature》及其子刊论文造假的丑闻,且据公开消息已基本坐实。这一现象暴露出几个关键问题:造假手段拙劣: 作为国际顶刊,这些论文备受关注。面对众多机构复现失败的情况,相关机构不仅未能给出合理解释,论文中反而被发现存在明显的数据篡改痕迹。“水刊”现状堪忧: 审核严格的顶刊尚且存在如此严重的造假问题,且需网友实名举报才能揭露,国内部分核心期刊、“水刊”的学术规范性更是不容乐观。造假已成常态: 这一系列事件初步印证,论文造假在当前的学术圈内已非新鲜事。二、 论文造假泛滥的深层成因论文评价体系与实际利益的高度绑定,是导致学术不端行为(如利用AI生成论文、找人代写、导师抢夺一作等)屡禁不止的核心驱动力。具体而言,可以分为两种截然不同的情况:1. 造假动机的分类与定性A情况(生存驱动/被动型): 许多科研人员(如面临“非升即走”的高校教师、有毕业压力的研究生)本身可能不具备充足的科研条件或精力,但在硬性考核指标的逼迫下为了生存而“凑数”。这好比“饿了三天去偷包子”,虽不合规,但在现有评价体系下有其无奈的客观原因。B情况(利益驱动/主动型): 部分学者为了评选院士、院长或正高等非必要头衔,在已有保障的情况下依然选择造假以牟取更高利益。这如同“为了买豪车去抢劫金店”,性质极其恶劣,完全无法原谅。近期曝光的顶刊造假事件明显属于此类。2. 惩戒机制薄弱与“甩锅”套路目前体制对学术不端的处罚过于轻微,导致造假成本极低。涉事机构在面对质疑时,往往采取以下几种套路应对:大事化小: 将明显的数据篡改定性为“图片管理不当”或“误用”,将主观造假降级为简单的失误。寻找替罪羊: 让课题组中无权无势的弱势群体(如挂名作者或普通研究生)承担责任,享受利益时没有份,出了事情却要“背锅”。冷处理: 避重就轻,拖延回应,等待舆论热度自然消散。三、 学术造假的严重后果与应对呼吁学术造假绝不仅仅是学术圈内部的道德瑕疵,它会带来实质性的社会危害:科研资源的严重浪费: 虚假的数据和结论会引导后续研究者在错误的方向上耗费大量的人力与物力。对公共资金与信任的背叛: 顶刊研究通常有国家基金支持,这些基金源自老百姓的税收。骗取基金不仅是对国家信任的辜负,更是对公共财富的挥霍。本质是经济欺诈: 带有基金支持的学术造假,本质上已经构成了经济欺诈。社会必须大幅提高对这类行为的处罚力度,让造假者付出相应的代价。即兴发挥版本一、近期学术乱象最近发生了两起著名的学术造假的丑闻,一个是同济大学的nature论文造假事件,另外一个是中山大学的论文造假事件。两起事件据公开消息,基本坐实存在造假的情况。由于两篇论文都是国际顶级期刊nature(包含子刊)。所以关注度较高,想要复现的机构也很多,所以被发现造假也很正常。从正常人的思维角度来看,我复现论文实验,没法成功,出现较大的差异,属于正常情况。但是当多家机构以及实验室复现实验都失败的情况下,论文发表的机构需要进行一个详细合理的解释。何况,这次两起事件,论文中都有明显的数据篡改的痕迹,可见造假手段之拙劣。由于是nature的缘故,所以这两篇有问题的期刊很快就被发现,且有网友进行实名举报,但是反过来想想? 那些不是顶刊的期刊或许会存在更加严重的问题。毕竟顶刊的审核相对来说都是比较严格的,但是依然出现了这么多的问题,可想而知,那么那些水刊呢? 国内的中科院top? 中文核心、北大核心?可以得到初步结论,论文造假在学术圈已经不是什么新鲜的事情了。二、什么导致论文造假泛滥呢?对于这个我倒是有很多亲身的经历。我曾经亲耳听到某理工类的高校的在读博士说自己的论文是gemini生成的,某某工程师或者学者找人代写论文,某某导师抢夺学生第一作者。此类事情实在是太多了,这些通通的导向了论文其实可以带来重大的实际利益。例如,一篇顶刊论文可以让老师评上一定的职称,可以申请更多的科研基金等等...… 所以论文在我国的评价体系中实在是非常重要,尤其在带有研究性质的机构中。但是,往往德不配位的情况会经常发生。我们需要一分为二来看,很多导师,因为种种原因,例如工作繁忙、家庭需要、自己科研能力差等等,实际上不具备什么科研的条件,但是受到学校和机构的要求必须要拿出一定的科研成果才可以满足考核要求,我称这种情况为A情况,主要代表不可抗因素逼迫发论文,经典代表为高校非升即走,研究生毕业要求等等。还有另外一种情况,例如某某老师为评院士、院长、正高等非必要的情况,从而需要有一定的学术成就,我称为B情况。在我看来A情况和B情况完全是两种性质截然不同的情况,像是本文一中描述的情况明显属于B情况,非必要的行为。若是为了A情况,从而去造假,貌似还有一定的合理之处,毕竟大家都是出来混口饭吃,基本的应付考核还是合情合理的。但是要是因为B情况从而去造假,那么我觉得完全不能原谅。虽然我承认,很多的论文造假是由于客观的要求不合理导致的,但是这也分为不同情况来看。为了非必要的事情进行造假,从而获取更多非必要的利益是完全错误的行为,我觉得和抢劫无异。我简单举个例子,假如我很贫穷,三天三夜没吃饭了,我去派出所食堂偷了5个包子吃。虽然这种情况属于非法,但是完全是事出有因,所以大概率不追究责任。但是假如我吃饱穿暖,但是我想买个豪车,所以我去抢劫金子,那么一定要受到相应的处罚。所以综上,我觉得B情况和抢劫金店无异,无非是方式不同罢了。那么是为什么让论文造假,抢夺学生挂名等等不端的事件屡屡发生呢? 原因是我们目前的体制对于论文造假的处理太过于轻微,造假事件即使被发现也无所谓,不会有什么严重的后果。就拿这次同济大学的事件来说。首先面对论文数据明显编辑过的情况,同济大学给出的结论是数据图片管理不当,存在误用现象。这一下就将事件由造假变为简单的失误。此外,退一万步,可以找课题组中的替罪羊来抗事情,这个替罪羊运气好点,可能是论文的挂名作者(二作以后),运气不好连挂名都没有。有道是“虽然这篇论文带来的利益你一点都分不到,但是一旦出事就都是你一个人干的哦”,简直是猥琐至极。我们看最后同济大学的nature的一作那位博士后,虽然估计要担责,但是好歹也算是有一作,某种程度上来说也算是死得其所了,千万不要找一个无权无势的普通研究生来顶啊。那也太残忍了。除了大事化小、寻找替罪羊这两种手段,还有就是可以冷处理,等舆论过去也就算了。三、论文造假会带来什么后果呢?论文造假带来的客观影响就是,会导致浪费大量的人力物力在错误的方向上。大部分顶级的论文都有国家的基金支持,基金的来源是老百姓的税收。所以带有基金的顶级论文造假往往更加恶劣,毕竟假如只是水刊没有基金,那么造假就算了,一是不会有多少人关注没有影响力,另外就是,本身也是自费研究。但是有了基金就完全不是这样了,一旦带有基金就说明你的项目是党和人民对于你的信任,支持你研究,你的研究就不再是你自己的事情了,你需要为你所花费的每一分钱做出一个交代,为信任支持你的力量付出相应的责任。所以我觉得需要加大对于论文造假的处罚措施,这某种程度上就是经济欺诈,需要付出相应的代价。
-
深度调研:主流虚拟机与容器 GPU 直通(Passthrough)方案全解析 在高性能计算、深度学习及远程桌面(VDI)领域,如何让虚拟机(VM)或容器高效地调用宿主机显卡资源是核心课题。本文总结了目前主流的显卡直通技术路径,涵盖 Docker、Type 1/2 虚拟机及风扇控制等配套方案。一、 容器化方案:Docker GPU 调用对于不需要完整操作系统开销的场景,Docker 是最简便的选择。核心工具:nvidia-container-toolkit。实现方式:无需特殊启动命令,只需在标准 Docker 命令中加入 --gpus 标志。示例:docker run --gpus all nvidia/cuda:12.0-base nvidia-smi限制:目前该方案主要适用于 NVIDIA 显卡。二、 虚拟机监控器(Hypervisor)方案对比根据底层架构的不同,显卡直通的难度和稳定性存在差异。1. Type 1 Hypervisor(原生型)直接运行在硬件上,性能损耗极低,是生产环境的首选。平台特点直通方案Proxmox VE (PVE)开源、功能强大通过修改 vfio 配置实现。支持 TCC 模式切换(可将普通卡伪装成 Quadro 专业卡)。VMware ESXi企业级稳定8.0 免费版即可实现 GPU 直通,且 Linux 虚拟机下无需额外授权。Windows ServerWindows 环境友好使用 DDA (Discrete Device Assignment) 实现稳定直通,优于不稳定的 GPU-PV。2. Type 2 Hypervisor(托管型)运行在操作系统之上,通常用于个人开发环境。VMware Workstation:支持添加 PCI 设备进行显卡直连,但在性能和稳定性上略逊于 Type 1。Oracle VirtualBox:教程较少,直通复杂度高。三、 重点实战路径与教程索引🔹 Proxmox VE (PVE)PVE 在显卡直通上的灵活性最高。通过在直通设备上修改显卡 ID 为 Quadro 系列的 DeviceID,可以强行开启 TCC (Tesla Compute Cluster) 模式,这对提升计算效率非常有帮助。实战参考:PVE 8.4 针对 2080 Ti 及 3090 的直通指南已非常成熟。🔹 VMware ESXi 8.0ESXi 的图形化界面操作相对友好。避坑指南:在 ESXi 8.0 中直通 NVIDIA 显卡至 Linux 系统时,需注意驱动版本的匹配,部分场景下需要调整高级设置参数以绕过驱动限制。🔹 Windows Server (Hyper-V)在 Windows 环境下,DDA 是唯一推荐的生产级直通方式。相比之下,GPU-PV(半虚拟化)虽然设置简单,但在高负载下容易出现不稳定的情况。四、 特殊硬件与配套调优1. Intel DG1/DG2 显卡目前 Intel 独显在 PVE 和 ESXi 上的直通已有成功案例,甚至可以配合群晖 SA6400 驱动进行视频转码加速。2. 散热与风扇控制显卡满载运行会产生巨大热量。在 PVE 或 Ubuntu 宿主机上,可以通过 fancontrol 和 pwmconfig 工具实现根据 GPU 温度动态调整主板风扇转速,确保硬件寿命。五、 调研结论与部署策略经过对比测试,针对不同应用场景,我们制定了以下最佳部署实践:目标系统推荐宿主机平台直通技术备注Windows 虚拟机Windows ServerDDA稳定性最高,兼容性最好。Linux 虚拟机ESXi 8.0PCI Passthrough部署便捷,无需授权即可满足生产需求。计算性能测试Proxmox VE (PVE)TCC Mode未来计划使用 PVE 开启 TCC 模式,若训练提升明显,将作为 Linux 的首选平台。💡 技术核心点总结:WDDM vs TCC:WDDM 模式兼顾显示和计算,但有系统开销;TCC 模式完全为计算而生,能够显著优化 CUDA 内存管理和任务调度。vGPU 注意事项:对于整租 GPU 场景,vGPU-Unlock 等补丁项目通常无实际增益,应优先考虑物理直通。下一步建议:如果你需要开始部署,我可以为你整理 PVE 开启 TCC 模式的具体指令集,或者 ESXi 8.0 直通时的常用参数配置表。你想先深入哪一部分?
-
如何避免DNS劫持? 常见的科学上网姿势是购买一个机场,机场会给你一个订阅链接,将这个链接填入客户端(例如Clash)后,客户端会通过订阅链接下载一个配置文件到本地。在新手阶段,大家更关注的是节点(Proxies)和规则(Rules),这两者共同决定了不同目标网站的流量路径。直到遭遇DNS劫持。常见的节点类型包括ss、vmess、http,它们都支持流量加密和伪装,但节点地址都是以域名的形式表达的,那么就涉及到域名解析(DNS)。为了表述方便,将全过程简化如下:客户端A----DNS1----|墙GFW|----节点M----DNS2----目标服务器X一般来说,M是“看上去”身份合法的,GFW会允许A正常解析M的IP地址并连接到M。而一旦到了M,剩下的问题就不大了,M负责联系X,并将加密、混淆后的数据传给A。但某些情况下,GFW会“破获”某些机场使用的节点M们,或者某段时间检测到某个M流量突增,一看传输内容都是混淆后的不知所云的数据,再一检测又发现它并不是一个正常的网站,就有可能将它列入“嫌疑人名单”。那么为了阻止A连接M,通常采取的措施之一就是DNS劫持。在“客户端A----DNS1----|墙GFW|----节点M----DNS2----目标服务器X”链条中,前两个是在GFW的“势力范围”。很明显,DNS劫持将在“DNS1”这一步来实现。例如,某个节点的域名是xeqdfik3.abc.top,它正确的解析地址应该是:67.229.123.123(位于洛杉矶)。当GFW怀疑它时,就会强行在“DNS1”这一步,将xeqdfik3.abc.top的解析地址劫持为:221.228.32.13(位于国内某省某ISP数据中心),那么A就连不上真正的M,整个数据链当然就被破坏了。不仅如此,该数据中心还会不断收到你的请求“给我转接网站X!我的认证密钥是!”这就太尴尬了。所以,我们需要仔细研究一下配置文件中的DNS相关设置,对它进行一番必要的改造。这个配置文件,就是通过订阅链接下载下来的文件,对于Clash来说通常后缀名是YML。dns段dns段以“dns:”开头,通常位于配置文件的靠前位置。需要重点关注其中的“default-nameserver”与“nameserver”配置项。其中nameserver是Clash日常使用的主要设置。如果仔细看过多家机场的配置文件,就会发现一个惊人的事实:default-nameserver与nameserver中,大量充斥着这样一些IP:223.5.5.5(阿里)、223.6.6.6(阿里)、119.28.28.28(腾讯)、119.29.29.29(腾讯)、120.53.53.53(腾讯)、180.184.1.1(字节跳动)……出于“保护”你的需要,它们都会将一些“怀疑对象域名”的DNS解析劫持到错误的地址,让你无法访问,或干脆跳到反诈网站首页,甚至可以让你直接跳转到新浪。你的亲密战友“M”很可能不幸被列入其中。那么,是否将nameserver换成可靠的DNS,例如:8.8.8.8(Google)、1.1.1.1(Cloudflare),就一定能找到M了呢?未必。使用可靠的DNS当然会返回正确的解析地址,但这个正确的结果能不能递到你手上就难说了。因为默认情况下,整个DNS查询过程对于ISP来说仍然是透明的,GFW/ISP知道你是谁,也知道你在什么时候向8.8.8.8提出了一个域名M的解析请求,这仍然会暴露整个“不法行径”。同时,由于整个交易地点是GFW/ISP的主场,它可以强行改变结果,仿佛戴上了一枚“现实戒指”。打个容易理解的比方:你在街头想买点毒品,根据配置文件,你找的卖方(DNS)是223.5.5.5,它和你完成了交易,但卖给你的是假货,你回家发现这粉一点儿劲都没有————这就是你使用默认配置文件时发生的事情。第二次你聪明了,你修改了配置文件,找到了正确的卖方(DNS)8.8.8.8,它和你完成了交易,它拿出来的也是真货,但全程有一个警察站在旁边,他“啪”地一下打掉了8.8.8.8给你的真货(解析结果数据包),然后反手塞给你一包普通面粉。————这就是透明代理下发生的事情。所以,我们需要用到DoH(DNS over Https)。将nameserver的表达形式从IP改成一个https链接,如下所示:nameserver:- https://dns.google/dns-query # Google - https://1.1.1.1/dns-query # Cloudflare这就把默认情况下通过53端口与DNS的明文通信,变成了通过443端口与DNS的Https加密通信。虽然整个交易仍然在GFW/ISP的主场进行,但现场多了一只牢不可破的保险箱,你把解析请求放入保险箱,而DNS从保险箱里读取请求,并把解析结果也放进保险箱,你最后从保险箱中拿到结果————整个过程是加密的。从理论上讲,你们交易的可能是“毒品”,也有可能是完全无害的两只苹果,这就让GFW/ISP的干预失去了“法理基础”。好了,经过千辛万苦,客户端A终于知道了M的真实地址,下面可以愉快地通信了。别急,在clash的安卓端,在dns:段还有一个单独的设置:clash-for-android:clash-for-android: append-system-dns: false顾名思义,它的意思是,在DNS解析的时候是不是要加上系统(指的是安卓系统)自身的DNS啊?如果是国内品牌的安卓手机,那当然是信不过的;那如果是类似三星这样的国外品牌手机呢?其实也一样,因为在默认情况下,安卓系统会从ISP那里获取DNS,通常是你所在当地的、延迟低的DNS,以保障网络的通畅。所以,只要你用的是国内的ISP,那都是不值得托付的啊!所以这一项必须是false。fakeip与geoip根据以上设置完,所有的DNS解析都非常可靠了,但牺牲了速度:用Google和Cloudflare的DNS解析国内的网站很慢,有时候甚至需要好几秒,这很不爽。因此可以借用Clash自带的fake-ip和geoip,将国内与国外的DNS解析分开,同时提供DNS缓存功能。在dns段增加fake-ip和geoip的设定,同时将nameserver重新设置成国内的DNS:dns: enhanced-mode: fake-ip fake-ip-range: 198.18.0.1/16 fake-ip-filter:- '*.lan' - '*.localdomain' - '*.example' - '*.invalid' - '*.localhost' - '*.test' - '*.local' - '*.home.arpa'nameserver:- 119.28.28.28 - 119.29.29.29 - 223.5.5.5 - 223.6.6.6fallback:- https://dns.google/dns-query - https://1.1.1.1/dns-query - 8.8.8.1 - 1.1.1.1fallback-filter:geoip: true注意,虽然nameserver又设置成了万恶的国内DNS,但fallback-filter设置为geoip为true,这一项确保了只有国内服务器地址才会被nameserve解析。国外服务器地址将使用fallback中的DNS——这就兼顾了安全与效率。开启fake-ip后,DNS服务器甚至不知道请求客户端的IP,这就进一步防止了泄漏。fake-ip还有一个好处是,由于它在DNS请求中加了一层(真实客户端IP-伪造的客户端IP),它还“赠送”了一个DNS缓存服务,这就使得你的DNS请求大部分时候直接从缓存中读取,无需请求DNS服务器,进一步提高了效率。需要注意的是,该模式下可能无法使用一些银行客户端APP,因为这些APP会检测客户端IP是否合法。一个局域网地址192.18.0.10显然不能过关。不过相信你应该知道如何设置Clash客户端的APP例外吧。hosts段对于机场提供的M们来说,你不需要了解它们指向的具体IP,因为很可能为了应对诡谲多变的网络环境,这些IP是会变化的,通过前文的措施进行可靠的DNS解析就可以了。那么还有一种节点,它是自建的,一般情况下,它的IP是固定的————这时候就可以采用更简单粗暴的方法:直接指定hosts。在配置文件中,hosts:段与dns:段平行,都属于最上一级。格式如下:hosts: "m01.abc.top": 152.22.10.10 "m02.abc.top": 69.13.125.105这样一来,啥DNS都不需要了,Clash将直接把域名替换成IP地址。解决了DNS劫持并不是万能的需要补充说明的是,前文都是围绕着如何把M的域名转换为真实的IP地址以建立连接,但对域名的DNS污染或劫持,只是GFW可能采用的部分手段,并非全部手段。GFW有能力直接屏蔽IP,这件事如果发生,那么M除了更换IP之外别无它法。幸好,GFW并不会滥用这个终极杀招,因为IP资源是有限的,某个IP也未必永远提供着“不良内容”,它有可能会被转手,也可能因为网络调整而变化。为了防止这件事发生,客户端A在和M接上头之后,如何进行隐蔽的通讯,减少M“毒贩”身份的暴露,也是有讲究的。tls加密常用的节点类型中,ss默认使用的是密码加密,也可以通过插件,再加上一层https,实现tls加密。而vmess和http原生就支持tls加密。但必须注意的是,我们需要在配置文件中指定这一点,才能强制它验证https证书和使用tls加密,以进一步确保数据的安全:tls: true skip-cert-verify: false当然,在这种设置下,要确保M的https证书保持更新。可以使用自动续期脚本来实现这一点。这样一来,客户端A与M之间传递的数据,将全部加密,某种程度上保护了M的安全,延长了M的“生命周期”。客户端设置配置文件经过上述的调整,已经可以满足安全要求。但在安卓版的clash客户端上,还有一些需要调整的地方。首先在“设置”-“覆写”-“DNS”-“策略”中,默认是“使用内置”,建议改为“强制启用”。这将强行使用配置文件中的设置,而不使用安卓系统内置的DNS服务。经过测试发现,移动运营商(联通、移动、电信在手机端)可能会不支持DoH,导致nameserver中的设置失效,其结果就是导致所有的M们都失联。这时候,Fallback Name Server的设置就派上了用场。在“设置”-“覆写”-“DNS”-“Fallback Name Server”中,添加8.8.8.8和1.1.1.1。当DoH不管用的时候,就会切换到这两个备用DNS。“覆写”功能是比较方便的,它让你不用每次都手动修改订阅链接下载下来的配置文件,而是用一套覆写规则自动覆盖相关条目。在“DNS”设置下,还可以参考前文,手动设置nameserver、添加Name Server策略等,此处不再赘述。原文来自lucyqin_blog: https://blog.lucyqin.cn/?p=1874
-
 解决未来的AI的能源问题?可控核聚变?太空GPU集群?(与gpt5.4对话) 对话整理:从“当前距离发明可控核聚变最大的难题是什么?”开始1. 可控核聚变当前最大的难题结论当前距离“真正可用的可控核聚变”最大的难题,不只是点燃一次聚变反应,而是:让高温等离子体长期、稳定、可控地维持实现持续净能量增益解决材料耐受问题解决氚增殖与工程化发电问题核心观点真正难的不是“做出一次聚变”,而是把它变成稳定、连续、可发电、可工程化的系统。本质上最核心的一关还是:高温等离子体的长期稳定约束。2. 用户提出观点:未来 AI 算力集群放到太空空间站更现实用户观点用户认为:AI 未来最缺的是稳定而强大的电力太空空间站可以依赖太阳能所以把 AI 算力中心放到太空,可能比地面更现实回应后的核心判断结论是否定的:短期到中期,太空空间站并不是更现实的 AI 主战场更像是特殊用途的补充路线主力训练集群在未来较长时间内仍然会在地面主要原因AI 集群真正缺的是大规模稳定供电 + 配套工程能力太空并不天然更好散热,反而更难发射、维护、换代成本极高不适合频繁扩容、维修和硬件迭代更适合做在轨边缘计算,而不是主力训练中心3. 关于太空站散热问题用户追问用户提出:太空太阳能似乎能解决电力问题那显卡散热有没有成熟方案?整理后的回答有,但要分清楚两件事:已经成熟的成熟的是:航天器电子设备热控方案其典型路线是:芯片/设备发热通过冷板、热管、液冷回路带走热量再送到外部散热器最后通过热辐射把热量排到太空还不成熟的不成熟的是:太空站超大规模 AI 显卡集群散热方案核心差别“少量高功耗电子设备在太空散热”已经是成熟工程问题“成千上万张 GPU 在太空长期训练”不是成熟方案本质难点太空里没有常规空气对流,最后只能主要靠辐射散热。 所以问题不在于“能不能给一张显卡液冷”,而在于:总热量怎么排出去散热器要做多大系统质量会不会暴涨结构和姿态控制会不会越来越复杂4. 用户提出:通信问题可以由 Starlink 解决用户观点用户认为:既然通信是问题那么 Musk 的 Starlink 也许能解决整理后的回答结论是:Starlink 能缓解通信问题但解决不了太空 AI 主力训练集群的根本问题原因Starlink 更适合解决的是:链路可达覆盖范围一般意义上的数据回传但不等于能解决:太空训练集群内部的超高速互联超大规模参数同步训练过程中的系统级网络要求核心判断Starlink 适合“在轨数据回传”和“边缘计算通信”不适合把太空节点直接变成地面 hyperscale 训练集群的等价替代品5. 用户进一步强调:训练过程完全可以在太空 GPU 集群上完成用户观点用户从算法工程师角度出发,认为:模型训练完全可以整体放在太空 GPU 集群完成这样就不需要反复依赖地面通信所以没必要过分担心通信问题整理后的回应这个前提只成立一半:如果训练全过程都放在太空,确实可以显著降低“地面—太空实时通信”的重要性但即便通信不是主问题,真正压人的仍然是其他更硬的工程问题真正更大的问题即使不考虑通信,仍然有四大核心障碍:1. 散热太空散热最终主要靠辐射功率越大,散热器面积和系统复杂度越高2. 供电系统整体质量不是“装太阳能板”这么简单发多少电,最终就要排多少热电力系统和热控系统是绑死的3. 空间辐射与可靠性高性能芯片在太空会受到辐射影响会出现软错误、位翻转、异常中断,甚至器件损伤对大模型训练来说,这类 silent error 很致命4. 维护与换代地面训练集群靠频繁更换 GPU、交换机、电源、冷却部件维持效率太空环境下维护和升级成本极高不适合像地面那样高速迭代最终结论通信不是太空训练集群最核心的障碍更核心的是:散热电力系统质量辐射可靠性维护换代成本6. 整段讨论的总判断最终整理结论从整段讨论看,形成的主线结论是:关于核聚变可控核聚变最大的难题,是把聚变从“实验成功”推进到“长期稳定、持续净增益、可工程发电”。关于太空 AI 集群太空算力并非完全没前景,但更现实的方向是:在轨边缘计算在轨推理在轨预处理在轨数据筛选与压缩而不是:把未来主力超大模型训练中心整体搬上太空一句话总结把 AI 算力搬到太空,最不该高估的是通信改善,最不该低估的是散热、供电、辐射和维护成本。7. 可作为文末备注的事实校正以下几条是这段讨论里涉及的、可由公开资料支持的事实:ITER 的目标之一就是实现并研究可由聚变自身加热维持的燃烧等离子体,这说明“长期稳定约束高温等离子体”仍是聚变工程中的核心难题。 oai_citation:0‡NASA空间热控的成熟路线确实是“热获取—热传输—热排出”,ISS 热控系统就是通过回路把热量送到外部散热器,再向太空辐射。 oai_citation:1‡NASAAxiom Space 目前推进的是轨道数据中心与在轨数据处理能力,定位更接近空间数据处理、AI/ML 与安全场景,而不是已经成熟可替代地面超大规模训练中心的方案。 oai_citation:2‡Axiom SpaceGoogle Research 公开讨论过空间可扩展 AI 基础设施设想,但其出发点是探索未来可能性,不代表“太空大规模 AI 训练集群已经工程成熟”。 oai_citation:3‡Google Research
-
开始正式备考11408了 以下是相关的计划,这学期学校的课程貌似很满,但是大多数都没啥用,课程的质量很低,所以课是能逃课就逃课,不能逃课就在课上学习,估计按照我的水平及时大多数时间都不听讲也可以满足课程最低的要求📅 考研 90 天计划(第一轮·进度打钩表)周次数学 (张宇30讲·新课)408 专业课 (一轮)英语 (红宝书 约35词/天 + 真题精读)政治进度打钩Week 1第 1 - 3 讲DS:线性表必考词 Unit 1-3 + 2010真题 Read 1-2少量了解[ ]Week 2第 4 - 6 讲DS:栈、队列、数组必考词 Unit 4-6 + 2010真题 Read 3-4少量了解[ ]Week 3第 7 - 9 讲DS:树与二叉树必考词 Unit 7-9 + 2011真题 Read 1-2少量了解[ ]Week 4第 10 - 12 讲DS:图、查找、排序必考词 Unit 10-12 + 2011真题 Read 3-4少量了解[ ]Week 5第 13 - 15 讲CO:系统概述、运算必考词 Unit 13-15 + 2012真题 Read 1-2少量了解[ ]Week 6第 16 - 17 讲CO:存储器、指令必考词 Unit 16-18 + 2012真题 Read 3-4少量了解[ ]Week 7第 18 - 19 讲CO:CPU、总线、I/O必考词 Unit 19-21 + 2013真题 Read 1-2少量了解[ ]Week 8第 20 - 22 讲OS:进程管理、同步必考词 Unit 22-24 + 2013真题 Read 3-4少量了解[ ]Week 9第 23 - 24 讲OS:内存、文件、IO必考词 U25-26 + 基础词 U1 + 2014真题 R1-2少量了解[ ]Week 10第 25 - 26 讲CN:物理层、链路层基础词 Unit 2-4 + 2014真题 Read 3-4少量了解[ ]Week 11第 27 - 28 讲CN:网络层基础词 Unit 5-7 + 2015真题 Read 1-2少量了解[ ]Week 12第 29 - 30 讲CN:传输层、应用层基础词 Unit 8-10 + 2015真题 Read 3-4少量了解[ ]🕒 每日时间模板(每日更新项)时间段科目任务描述状态08:30 - 09:30英语背单词[ ]09:30 - 10:30英语真题阅读 / 长难句[ ]10:40 - 12:00数学新课 / 公式 / 例题[ ]13:00 - 15:30408一轮主任务[ ]15:40 - 17:30408例题 / 章节题 / 总结[ ]17:30-18:30回家+跑步40分钟 [ ]19:00 - 21:30数学做题训练 / 错题整理[ ]21:30- 22:00政治 / 英语政治 or 补今日落下内容[ ]22:00休息+放松冥想洗澡生活[ ]执行了两天了,感觉状态还不错。大家可以在这里监督我并且给我提出一些建议。
-
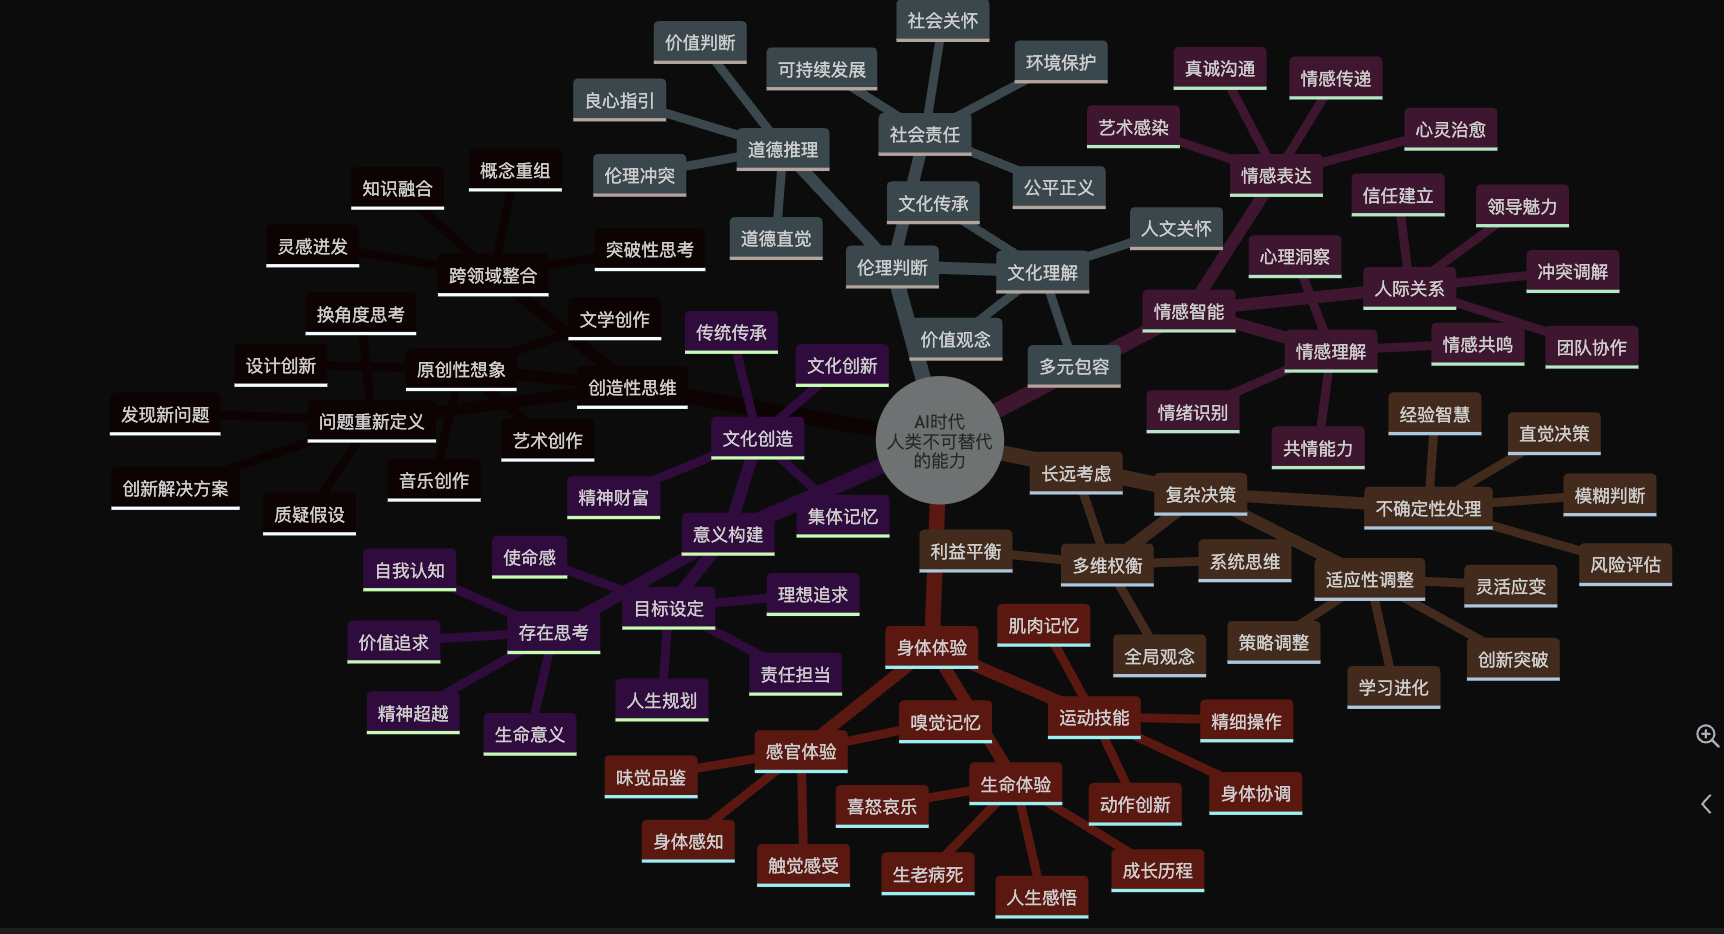
ai时代“热爱”尤其珍贵 随着ai时代爆炸的发展,在感叹于ai的能力强大的同时也在后怕,如此的一个强大且不知疲倦的东西是否真的可以替代我们? 现有的工作岗位是否都会被取代? 昨天晚上10点在和朋友交流的过程中,她问我什么岗位以后不会失业呢?确实把我问懵了,随之而来的是无穷的痛苦。结合最近和各种不同层次的人进行讨论的结果,我觉得需要进行总结下,大致分为的以下几种,顺便从一个程序员的角度聊一聊。一、认为容易且缺乏创造性的工作会失业认为低端且重复的工作会被取代,这个概念其实很不严谨。因为每个人对于“低端”、“重复”的定义不同,到底什么是重复性强? 什么是容易?显然我们需要一个清晰的逻辑,才能继续讨论。可能大多数人都认为有一些工作是重复性强的,是容易的。但是要合理的评价事情的容易以及重复性需要建立一个统一的评价指标。毕竟就像是一个简单的mlp(多层感知)的代码实现,对于一个资深的算法工程师来说很简单,但是对于一个大学生来说并不容易。该如何建立这个评价体系是个非常大的问题,如果纯从技术和学术的角度出发,任何已有的知识都是一个简单且容易的事情。例如,修建一条跨海隧道,有很多成功的案例,不困难。真的困难的是人类尚未解决的问题,例如大到,可控核聚变、常温超导体,小到大参数llm模型的幻觉问题。本质是“概率预测”而非“数据库”: LLM 的底层逻辑是下一个词预测 (Next-token prediction)。它们并没有像传统数据库那样存储具体的“事实”,而是通过海量数据学习到了词汇之间的统计和概率关系。当它生成一段看似合理的文本时,它是在进行概率拼接,而不是在“回忆”客观真理。缺乏对真实世界的真正理解: 模型没有常识,也没有物理世界的运行逻辑。只要生成的文本在语法和概率上是顺畅的,模型就会自信地输出,即使内容违背了客观事实。训练数据的局限性: 训练大模型的数据往往包含了互联网上的错误信息、偏见、甚至自相矛盾的内容。模型吸收了这些“有毒”数据,自然也会在输出中反映出来。这种一直无法真正的解决真正解决的问题或许才不算是简单且重复性质高。如果是这样,那就太可怕了,只有尖端行业的工作才有价值,大部分维持社会运转的工作都可以交给ai。其实仔细想想看,确实是这样的,ai是一个强烈的生产力工具,可以提升百倍千倍的生产力,这就会出现只需少部分人劳动,多数人躺平的情况发生。小结下,我觉得这种观念的到此为止就不攻自破了。毕竟根本站不住脚,抽象的说,其实和50步笑百步差不多,因为大多数的工作哪怕是有着创造力的工作,只要被量化后,ai都可以很好的处理。二、认为ai很笨,完全不可能替代这里才是最恐怖的,大多数人都没意识到ai的到来或许比前几次工业革命更加爆炸。由于多数人的信息闭塞,用不到人类目前相对顶级的ai,又或者是不屑一顾连用都不用。作为一个AI boy我可以负责任的告诉大家,目前ai的水平在所有的行业中已经是顶级高校博士的水平了,甚至某些层面超过了全部的人类。我觉得首先要正视AI,理性的分析。这类观点常见的论据大概有几种:“它没有意识,所以永远不可能做出真正的创造。”“它只会抄袭和拼接,不会自己思考。”“它现在写的东西一眼就能看出来很假。”这些话听起来都没错,但问题在于:它们讨论的是“终极形态的 AI”,而我们真正要面对的是“工具形态的 AI”。绝大多数岗位被替代,并不需要 AI 具备意识,也不需要它原创出莎士比亚级别的作品,只需要它能够把工作流程拆成若干小步骤,并在其中的大部分步骤上做到:更快、更便宜、更稳定。举个不那么极端、但更贴近现实的例子:一个岗位每天要写 50 封邮件、整理 20 份文档、做 10 次对比、开 5 个会。AI 不需要把“整个岗位”一次性干掉,它只要把邮件写作、文档归纳、信息对齐、会议纪要、简单决策建议这些环节做到 80 分。组织就会发现:原来 10 个人做的事,变成 3 个人加上 AI 就够了。这里面最关键的误区是:大家习惯用“AI 是否完美”去判断“岗位是否安全”。但市场的逻辑从来不是完美主义。对企业来说,替代的阈值往往是“足够好 + 足够便宜”。对个人来说,最危险的不是 AI 比你强,而是 AI 让“你的优势不再稀缺”。所以我并不担心 AI 会不会写出诺贝尔文学奖级别的文章,我更担心的是:那些原本需要你花 5 年才能熟练掌握的技能,可能被一个提示词压缩成 5 分钟。三、真正不会轻易被替代的:热爱驱动的“长期主义”如果前面两种观念都站不住脚,那剩下的问题就变得更尖锐了:在 AI 提升生产力、压缩学习曲线、稀释技能壁垒之后,我们还靠什么区分自己?我越来越觉得答案不在“技能清单”里,而在一个看起来很虚、但极其硬核的东西上:热爱。这里的热爱不是鸡汤式的“做你喜欢的事”,而是指一种能力:你愿意在短期没有回报时继续投入你愿意在枯燥重复时继续打磨你愿意在别人放弃时继续向前当 AI 把“入门”变得廉价,把“标准答案”变得唾手可得时,人和人的差距会更集中地体现在两点:你会不会提出更好的问题。你愿不愿意把一个问题追到足够深。而这两点,往往需要热爱来支撑。因为深入意味着孤独,意味着反复被否定,意味着很长一段时间里你看不到掌声。更现实一点说,未来很多工作的核心竞争力可能会从“会做”变成“持续做”。会做方案的人会越来越多。会写代码的人会越来越多。会做内容的人会越来越多。但能持续三年、五年、十年,在一个领域里迭代自己的认知、审美、判断力的人,依然稀缺。稀缺的东西才有议价权。小结所以我现在更愿意把“不会失业”理解为:不是你永远安全,而是你永远有重新开始的能力。而热爱,是这种能力最稳定的燃料。
-
frp内网穿透体验 1.背景我有许多内网穿透的场景,大多数都使用zerotier或者tailscale等虚拟局域网(vpn设备)来进行穿透,有好处也有坏处,好处是所有的设备都在一个局域网中,坏处是要手动nginx的stream映射到公网中,而且当所处网络环境不好或者网络十分不稳定等情况,虚拟局域网的方案大概率没法快速打通直连,而且会发生丢包等一系列难以使用的情况。基于以上种种情况,frp出现了,frp 非常适合对外暴露内网的远程22端口。2.什么是frp?以及frp的原理FRP 是一个基于 TCP 的“反向代理 / 端口转发工具”,用于把内网服务稳定地暴露到公网。原理图如下:[ 内网机器 A ] --(frpc)--> [ 公网服务器 ] <--(访问)-- [ 外部机器 B ]可以看到frp的通信顺序,由内网机器主动访问公网服务器,然后将服务暴露在公网服务器的某一个端口中,这样就可以绕过内网机器的服务被nat挡住的困境。frp的核心思想,既然外部访问无法主动找到我的内网服务,那么我的内网服务就全部使用出的方案,主动和具有公网的机器进行沟通,就像是一只苍蝇一直和公网机器说:有服务通过你请求我吗?平常公网机器的回答都是否,但是一旦真的有请求,那么就会回答是然后回复请求内容给内网机器。在这过程中,内网机器就像是金枪鱼,必须一直不停的游动(和公网机器进行沟通),不能停下。为什么内网机器必须不停的主动询问公网机器呢?原因就是nat的规则,nat普遍只接受自己发送的请求的回包,一旦停止访问,公网机器转发外部服务的回包就不能进来了。所以frp的可靠性很高,毕竟所有机器对一台公网服务器的访问能力都不会太差的。3.具体如何使用frp?本节按照真实部署顺序说明 FRP 的使用方式,从环境准备到系统服务化,适合长期运行。3.1 FRP 是什么(一句话定位)FRP 是一个基于 TCP 的反向代理工具,用来把内网服务稳定暴露到公网。核心思想只有一句话:外部不能“入”,那就全部改成“内网主动出”。3.2 整体架构说明FRP 至少需要两台机器:[ 内网机器 ] ── frpc ──▶ [ 公网 VPS ] ── frps ──▶ 外部访问者角色说明:frps(服务端)部署在有公网 IP 的 VPS负责对外监听端口frpc(客户端)部署在内网环境(家里 / 公司)主动与 frps 建立长连接3.3 下载与安装 FRP(两端一致)以 Linux amd64 为例:wget https://github.com/fatedier/frp/releases/download/v0.52.3/frp_0.52.3_linux_amd64.tar.gz tar -zxvf frp_0.52.3_linux_amd64.tar.gz解压后目录结构如下:frps frpc frps.toml frpc.toml⚠️ 注意事项:frps 与 frpc 版本必须完全一致建议统一放在固定目录(如 /opt/frp_xxx)3.4 服务端配置(VPS:frps)3.4.1 编辑frps.tomlbindPort = 7000 auth.method = "token" auth.token = "替换为你自己的强随机字符串"参数说明:bindPortfrpc 连接入口端口(不是业务端口)auth.token防止未授权客户端接入3.4.2 手动启动测试./frps -c frps.toml出现以下日志即表示启动成功:frps started successfully3.4.3 放行防火墙与安全组端口(必须)VPS 本机防火墙(如 ufw):sudo ufw allow 7000/tcp sudo ufw allow 11808/tcp # 示例业务端口云厂商安全组:入方向放行 TCP 7000入方向放行 TCP 11808(或你实际使用的端口)3.5 客户端配置(内网:frpc)3.5.1 编辑frpc.tomlserverAddr = "VPS公网IP" serverPort = 7000 auth.method = "token" auth.token = "与frps保持一致" [[proxies]] name = "ssh-home" type = "tcp" localIP = "127.0.0.1" localPort = 22 remotePort = 11808含义说明:VPS:11808 → 内网机器:223.5.2 手动启动测试./frpc -c frpc.toml成功标志:login to server success start proxy success3.5.3 外部连通性验证在任意公网机器上执行:ssh 用户名@VPS公网IP -p 11808能够登录内网机器即表示穿透成功。3.6 将 frpc 设置为系统服务(开机自启)生产环境禁止使用 nohup 启动3.6.1 创建 systemd 服务文件(内网机器)sudo nano /etc/systemd/system/frpc.service内容如下:[Unit] Description=FRP Client Service After=network.target Wants=network.target [Service] Type=simple User=你的用户名 WorkingDirectory=/opt/frp_0.52.3_linux_amd64 ExecStart=/opt/frp_0.52.3_linux_amd64/frpc -c /opt/frp_0.52.3_linux_amd64/frpc.toml Restart=always RestartSec=5 LimitNOFILE=1048576 KillSignal=SIGTERM TimeoutStopSec=10 [Install] WantedBy=multi-user.target3.6.2 启用并启动服务sudo systemctl daemon-reload sudo systemctl enable frpc sudo systemctl start frpc检查状态:systemctl status frpc3.7 将 frps 设置为系统服务(VPS)3.7.1 创建 systemd 服务文件sudo nano /etc/systemd/system/frps.service[Unit] Description=FRP Server Service After=network.target Wants=network.target [Service] Type=simple User=root WorkingDirectory=/root/frp_0.52.3_linux_amd64 ExecStart=/root/frp_0.52.3_linux_amd64/frps -c /root/frp_0.52.3_linux_amd64/frps.toml Restart=always RestartSec=5 LimitNOFILE=1048576 KillSignal=SIGTERM TimeoutStopSec=10 [Install] WantedBy=multi-user.target3.7.2 启用并启动服务sudo systemctl daemon-reload sudo systemctl enable frps sudo systemctl start frps3.8 最终验收流程(必须完成)VPS 侧:ss -lntp | grep 7000 ss -lntp | grep 11808内网机器:systemctl status frpc重启测试:sudo reboot重启后确认:systemctl status frps systemctl status frpc3.9 常见问题汇总(踩坑记录)域名解析错误 → frps 日志无任何连接token 不一致 → EOF / session shutdownnohup 与 systemd 同时运行 → proxy already exists云安全组未放行业务端口使用 IPv6 但未放行 IPv6 防火墙规则
-
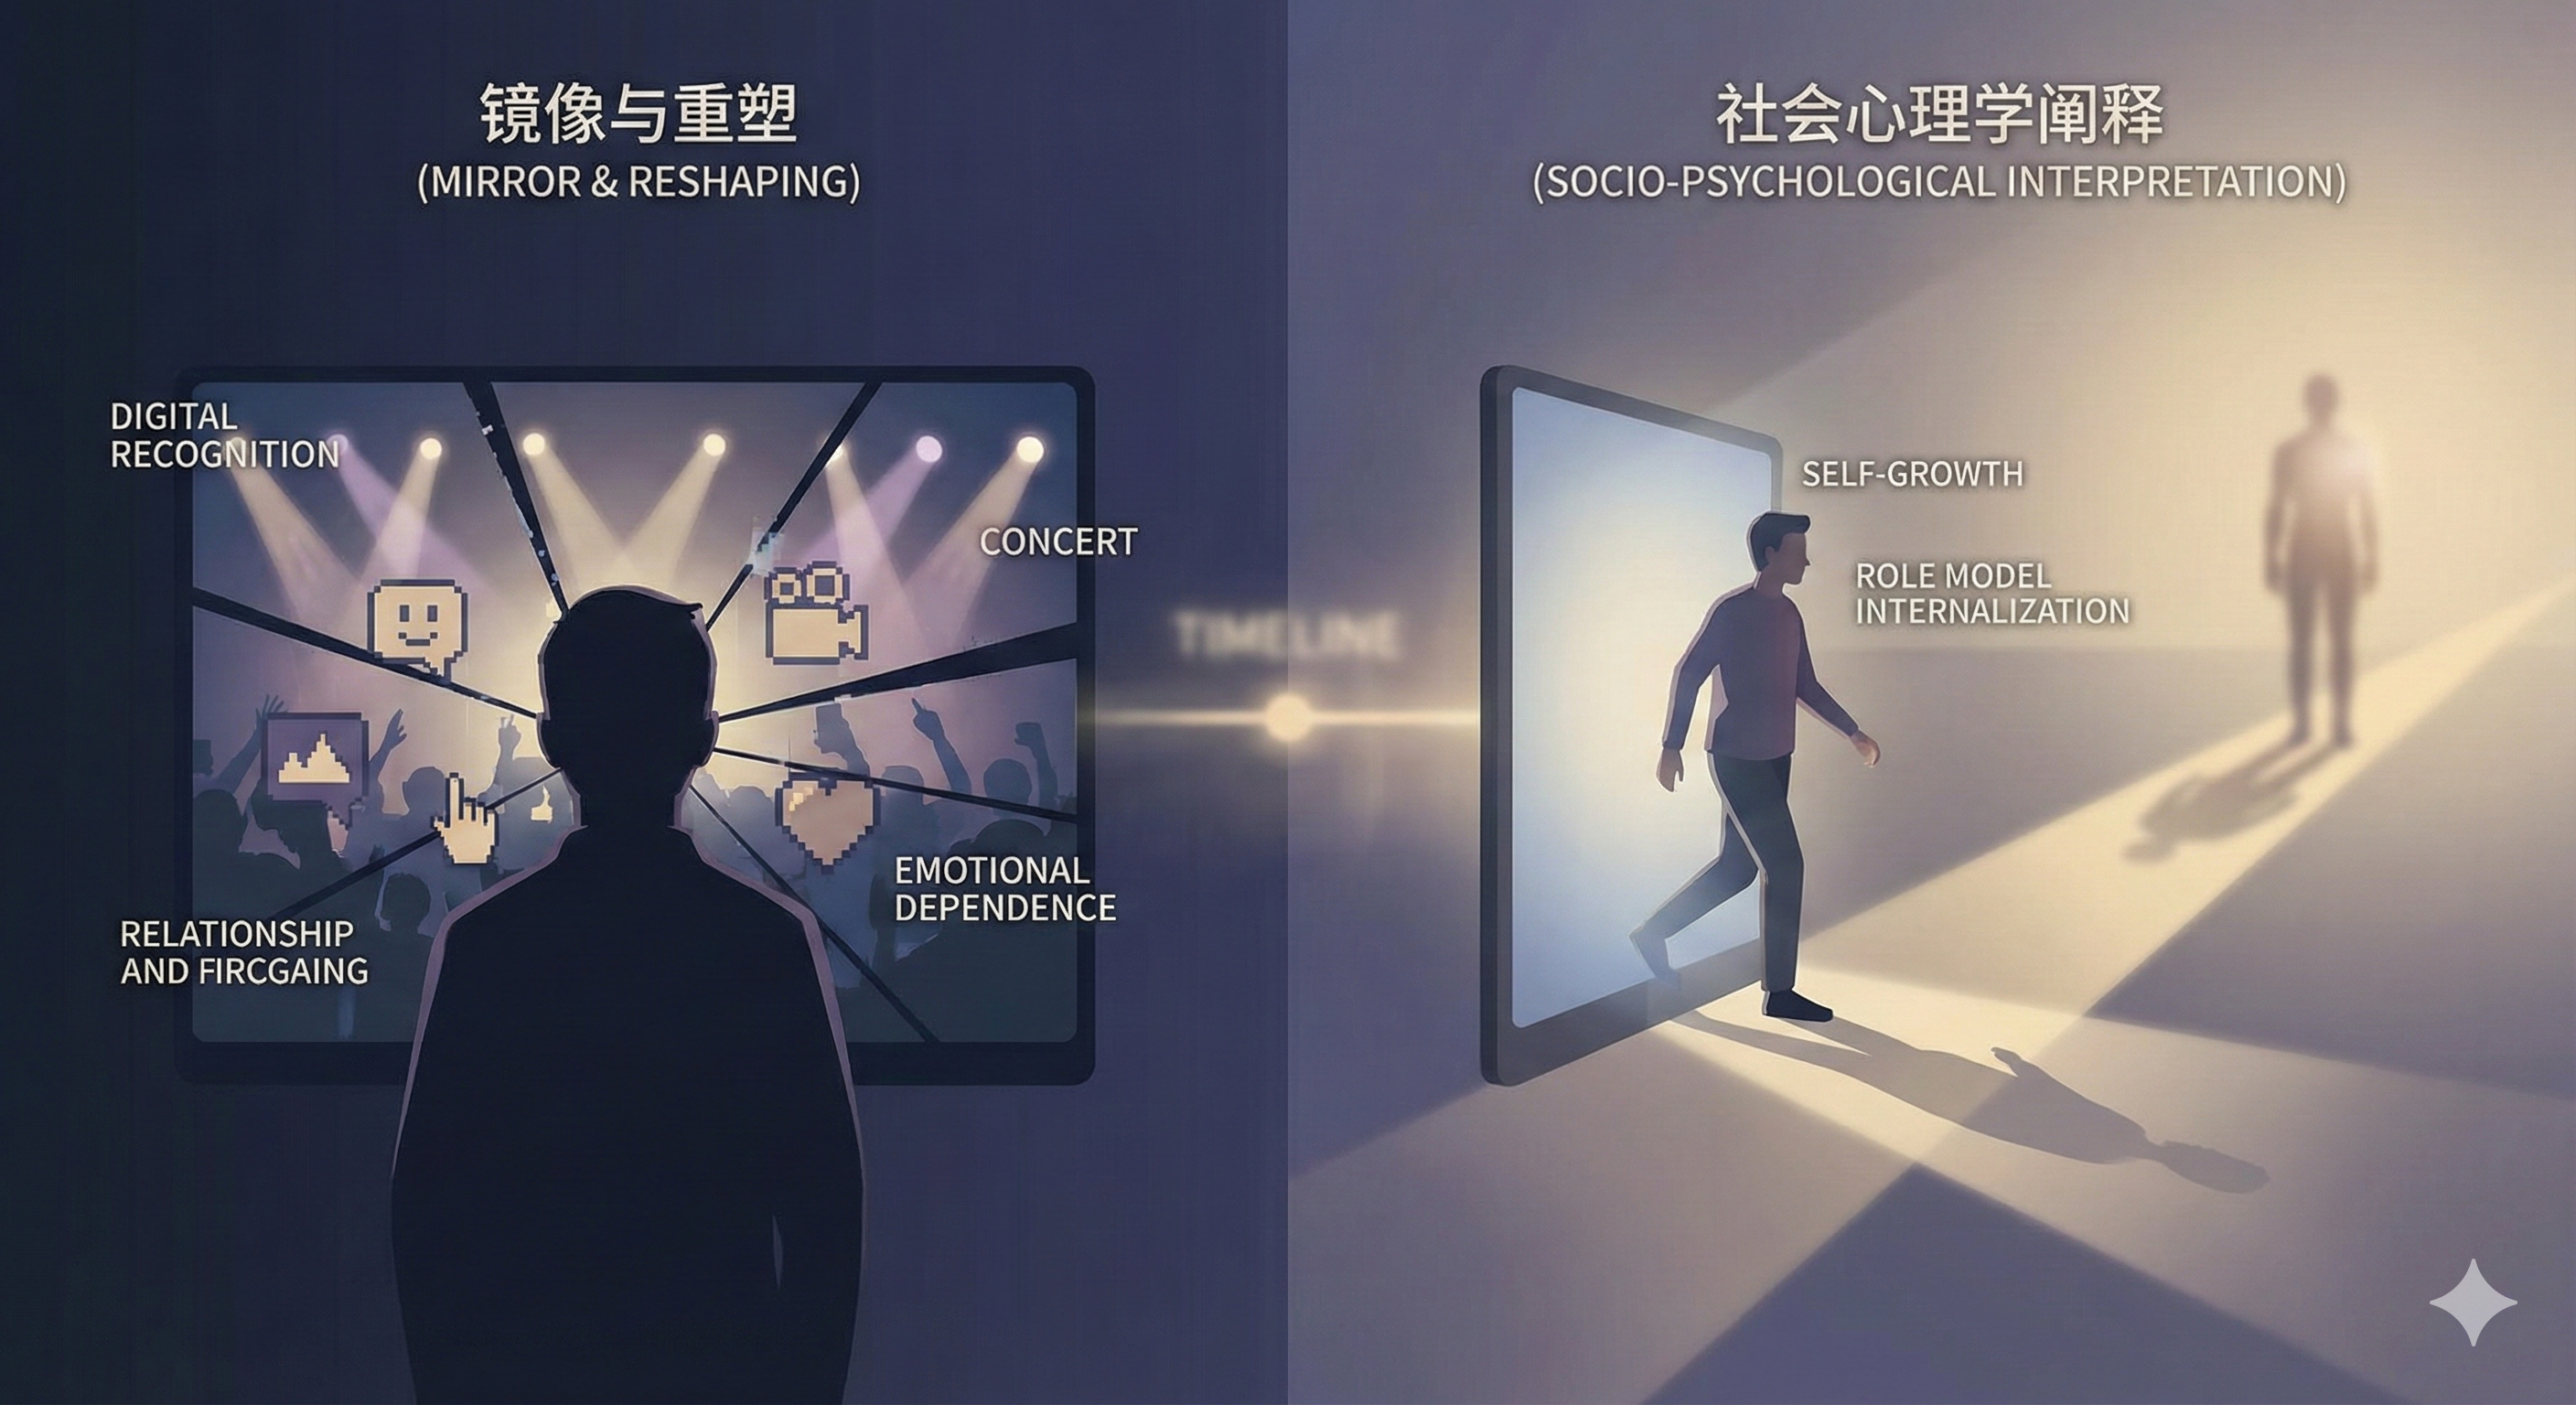
拒绝做情绪的“供养者”:如何把追星变成一种自我投资? 注意本文由timelocked写成,gemini进行润色一、 概念界定:基于数字语料库的现象学重构在2025年的数字认识论语境下,对某一社会现象的定义已不再单纯依赖传统的词典学解释。大型语言模型(LLM)作为人类公开文本语料库的聚合体,实质上反映了某种“集体潜意识”的共识。通过检索 GPT-5 对“追星(Fandom)”的定义,我们获得了一个具有批判性的概念框架:“追星本质上是个体将现实中匮乏的身份认同(Identity)、情绪价值(Emotional Value)与意义感,投射至非真实社会关系中的客体身上。” 这一算法生成的定义揭示了该行为的双重性:它既是心理代偿的机制,也潜藏着主体性丧失(Loss of Subjectivity)的风险——即当“客体的人生”置换了“主体的人生重心”时,异化便产生了。二、 样本观察:大学生群体的迷群生态基于对当代大学生群体的参与式观察(Participant Observation),当前的追星行为呈现出显著的社会统计学特征:性别维度的非对称性:迷群构成表现出明显的性别失衡,女性群体在活跃度与参与深度上均占据主导地位。对象的符号化特征:追捧对象高度集中于“流量艺人(Traffic Stars)”(占比逾70%),此类对象通常具有强资本包装与符号消费特征;其次为体育竞技明星。仪式化的互动模式:追星行为已从单向的喜爱转化为一种资本与时间密集型的仪式性互动。线下参与(演唱会、见面会)与线上消费(周边购买、数据维护)构成了其核心的行为脚本。三、 归因分析:社会化进程中的心理代偿从社会心理学视角审视,追星并非孤立的娱乐行为,而是原子化社会中个体应对“存在焦虑”的防御机制。人类在社会化(Socialization)完成后,对“认同感”的需求具有生物学与社会学的双重必然性。当现实生活场域(学业、职场)无法提供足额的自我效能感(Self-Efficacy)与归属感时,个体便倾向于寻求替代性满足:对内投射:偶像作为“理想自我(Ideal Self)”的完美镜像,满足了个体的幻想需求;对外连接:趣缘群体(Interest-based Community)提供了一种低门槛的高凝聚力社群,缓解了个体的孤独感。四、 规范性探讨:从“偶像崇拜”到“榜样内化”对于当下主流的消费主义追星模式,本文持审慎的批判态度。若追星行为仅停留在短期的感官愉悦与虚拟的情感寄托,其本质是对现实空虚的逃避。理想的追星范式应当完成从“情感依附”到“特质内化”的跃迁。正如格言所云:“不要怀念我,去成为我。”(Do not miss me, become me.)这标志着追星行为的伦理转向:行为的工具化:偶像不应是终极目的,而应成为自我成长的工具与参照系。价值的萃取:应当剥离偶像的娱乐符号,提炼其核心精神特质。例如,克里斯蒂亚诺·罗纳尔多(C. Ronaldo)所象征的坚毅精神,或某些公众人物在公共领域表达观点的勇气。唯有在“求同存异”的基础上,完成对优良特质的“剥离—学习—内化”过程,追星才能具有建设性的社会意义。五、 路径修正:去魅与近源榜样的回归当前的“流量崇拜”往往建立在资本构建的拟态环境(Pseudo-environment)之上,具有极高的不稳定性(如形象崩塌风险)与虚无感。因此,构建健康的认同感体系,应当尝试“去魅(Disenchantment)”。相比于遥不可及的商业明星,将关注视线回归至生活周遭的普通人(Ordinary People),寻找那些在日常生活中展现出人性光辉的“近源榜样”,或许能为个体带来更为持久且真实的心理滋养。
-
2025年度总结 一年又一次的过去了,今年发生了很多事,尤其是有很多个人生第一次,所以做个总结吧。今年有很多个第一次:第一次,尝到了被合伙背刺的感觉,但是缓了一会依然保持对人的热情和友善,虽然很伤心,但是也从中学到了很多。第一次,找到实习工作,并且好像工作的还不错。第一次,买了一台高性能的mac,m4pro+48g内存的配置。是梦想中的电脑,也算是实现了之一的梦想。第一次,拥有一台属于自己的独立服务器。第一次,参与开发能够上线的项目。第一次,去了趟上海,主要是找朋友打游戏,然后就回来了,一直对城市景观没啥兴趣。第一次,去阿里的上海园区。第一次,和朋友两人独自去川西自驾旅游,平均海拔3500,最高海拔4900,体会到了作为牵头人的责任,以及对大自然的敬畏。第一次,去徒步,负重40斤,从武功山的沈子村,一路徒步到金顶,历时11小时,平均150的心率,可谓是爬过最累的山了,但是景色确实绝美。第一次,来到海拔4000多米的稻城亚丁,在四姑娘山下用融化的冰川学漂流。第一次,拥有理想的无人机air3s,童年时代只有钱买低价的精灵3se。第一次,有勇气和喜欢6年的高中同学表白,虽然我是个e人,但是母胎单身20多年了,在这方面没啥经验,可能有些自卑。找了很多同学,要到她的微信通过后客套几句直接表白,结果嘛,自然是被发好人卡了。记得当时发那条消息的时候是在天空之城理塘。提醒下大家,要敢于尝试,不然就只能像我这样得到一张好人卡。第一次,实际运用了很多新的技术,nginx反代,docker容器,pytorch,以及很多深度学习的知识。第一次,买了一套音响系统,左右监听音响和低音炮。第一次,每周坚持跑3到4次5km,并且有了最好23分钟的成绩。第一次,成功减肥20多斤,之前天天coding,加上吃药等原因不运动导致身体很差,胖了40多斤,想当年我也是个体育达人哎,足球、乒乓球都玩的不错。于是下定决心要减肥,从8月份到12月份成功减肥中。第一次,开半专业卡丁车,是那种赛车手练习用的4t级别的卡丁车,虽然开了一共不到3000块钱,但是也打破了车厂的圈速记录。
-
人生的十字路口,该如何抉择? 1.最近面对的疑惑最近面临了一个选择,到底是孤注一掷的考研南京大学,还是利用这两年学好技术? 看起来是不是很难选择? 第一,南京大学作为一所985院校,考研的难度很大,而且我的本科还仅仅是一所211的独立学院,对比那些想要考取南京大学的竞争对手来说,我的本科显得十分不堪。第二,一旦确定要考研,意味着是一场豪赌,不成功,就基本算是白努力了。而且还要放弃几乎全部在技术水平上的经历。这意味着,如果不成功,那我在技术水平上也算是失败了。所以,如何抉择? 看起来很难。2. 别人给我的建议lucyqin的建议很犀利,“如果考不上顶级的院校(985或顶级211),那你读研究生还不如直接出来工作”。并且还指出,以他对我的了解,我不适合在考试这个领域和别人pk,这不是我的优势。目前要做的,是需要尽快的理解技术和需求如何紧密结合在一起,多思考,做出在新时代可以立足的东西。总体来说偏向于实践,潜意识学历不重要。并且在ai时代,技术的迭代非常迅速,可能在一些垃圾的院校里浪费3年的时间,再出来就真的太晚了。jack和L的建议倒是完全相反,你这个年纪应该全力去考取研究生的,而不是学什么技术,什么项目经验。jack认为,当前的技术革新速度太快,像是以前可以依靠过硬的一门技术就可以吃老底的时代不存在了。大量的基础岗位会被ai取代,而行业内偏高级的岗位,往往入职的学历门槛很高,所以当前还有条件提升学历的话,尽量全力去争取,这样或许才有一线机会。补充一小点,jack 和lucyqin在各个行业中都是非常成功的人,但是两个人,却给出了不同的建议。于是,我就很矛盾了,如何抉择呢?3.我的看法lucyqin大约是1998年参加的高考,分数可以说是举世惊人的,可以说中国任意一所大学的任何专业都可以随便选择。但是由于当时是先填写志愿然后考试的,所以只是上了东南大学的王牌专业。可以说学历一直是他的优势,虽然和他的个人能力相比学历不算什么。而jack的情况和lucyqin的情况相反,jack的学历非常一般,但是成就却是不比lucyqin低。两人的观点基于两人的经历来看其实各有道理,lucyqin从来没有因为学历发愁过,所以会更加聚焦实际做的怎么样。jack 的话,可能实践做的很好,创办自己的公司,做的不错,但是学历只能那样了,所以在jack的眼里,实践反而不重要,学历反而重要了。我的看法,其实每个人的建议都只能是建议,人生需要自己选择。曾经无数次问自己,我真的想要什么? 人不可能在同一时间内既要又要的。我是一个及时行乐主义者,希望得到他人的认可,希望有存在感。其实每个选择站在第三者的角度本身都是有得有失的,所以选择本身不重要。重要的是做出选择了后如何推进下去。没人可以给你打包票,但是有一点可以确定,永远都不要把希望寄托在别人身上,哪怕是父母。这个世界上其实真的可靠的只有自己。还是决定踏上考研路,或许是想要真的证明下自己吧,又或者说希望有一个名校的title吧。